

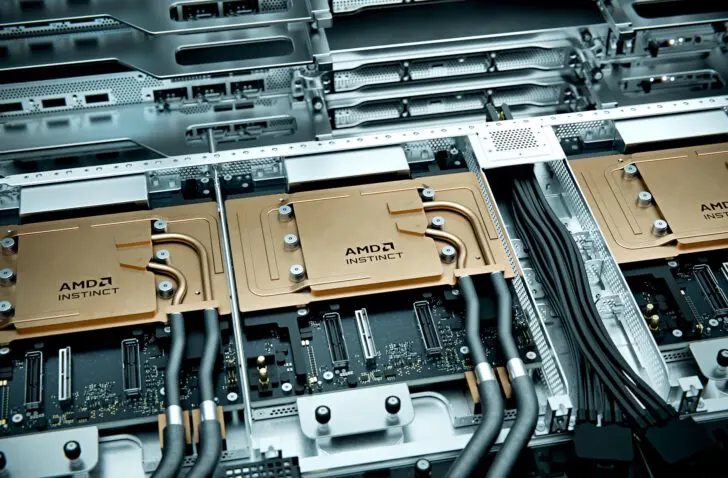
L’Instinct MI455X est le GPU le plus puissant jamais construit par AMD : 320 milliards de transistors gravés en deux nanomètres, 432 Go de HBM4 et jusqu’à 40 pétaflops de puissance de calcul FP4. Pourtant, cette génération, l’histoire porte moins sur la force brute que sur l’efficacité et le rôle du GPU dans un ensemble plus vaste.
« L’objectif n’est plus de construire le plus gros GPU. Même si nous en avons construit un assez gros », plaisante Alan Smith, Corporate Fellow et architecte en chef de la ligne Instinct, lors du briefing technique à San Francisco à la conférence AMD Advancing AI.
« L’objectif est de construire un système qui s’aligne sur les modèles de communication et d’exécution des charges de travail d’IA. Les modèles et l’infrastructure évoluent ensemble ; le prochain bond en avant des performances de l’IA proviendra de la conception conjointe des deux comme un tout. » Le MI455X est donc indissociable d’AMD Helios, le rack dans lequel 72 de ces GPU collaborent comme un seul système.
CDNA 5 en 2 nanomètres
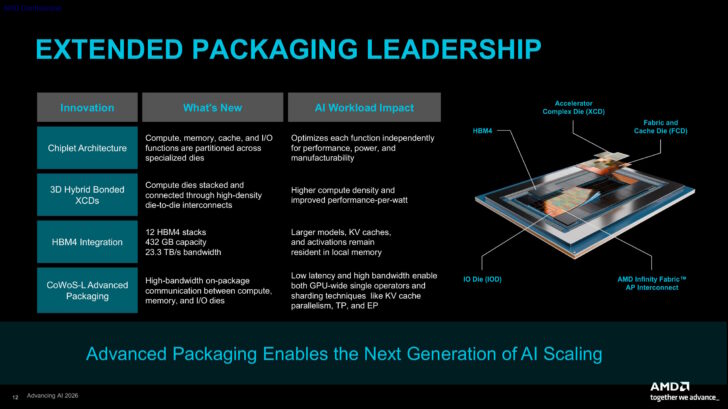
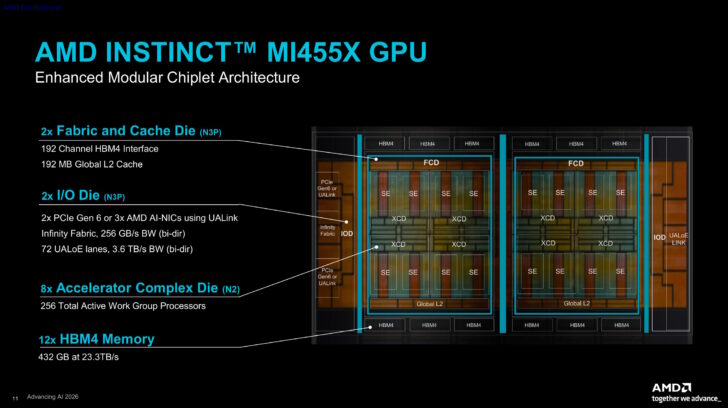
Le MI455X s’appuie sur la nouvelle architecture CDNA 5 et est l’une des premières puces utilisant le procédé en deux nanomètres de TSMC. Il s’agit toujours d’une conception en chiplets, mais la disposition est totalement revue. Huit accelerator complex dies (XCD), produits en 2 nm, abritent ensemble 256 processeurs de groupes de travail actifs.
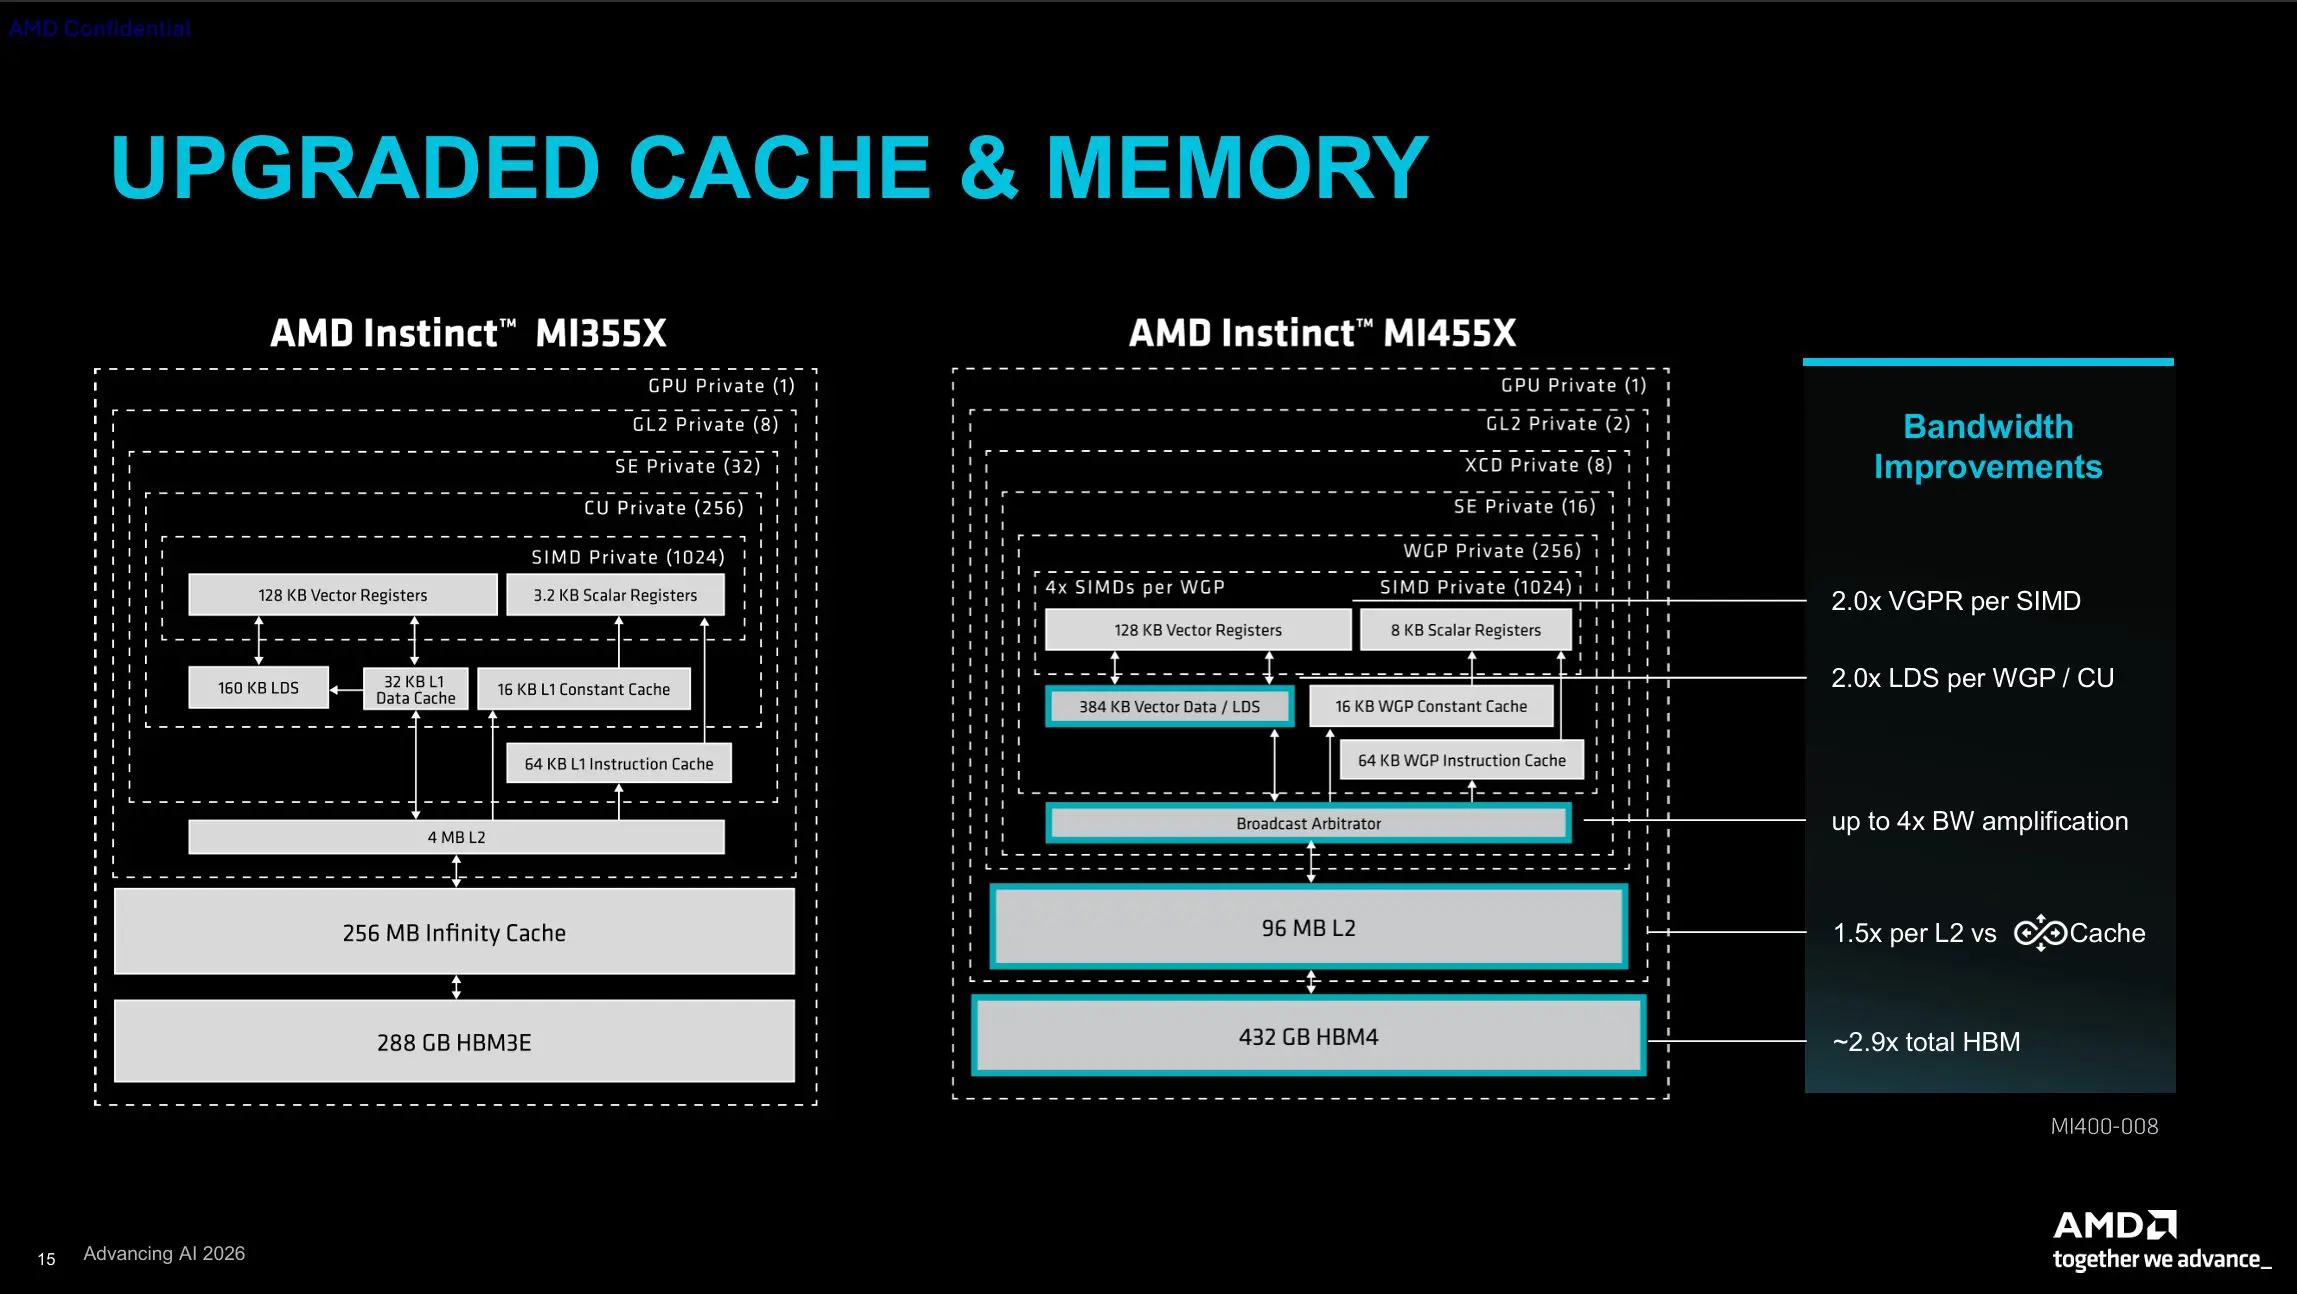
Les deux fabric-and-cache-dies (FCD), gravés en TSMC N3P, sont nouveaux : le cache L2 y a été déplacé, désormais sous forme de deux blocs de 96 Mo partagés chacun par huit moteurs de nuanceurs (shader engines). Avec deux dies d’E/S, le tout est assemblé avec le packaging CoWoS-L et le bonding hybride 3D. Cette redistribution offre trois fois plus de bande passante de cache que l’Infinity Cache du MI355X, et jusqu’à quatre fois plus d’amplification de bande passante en envoyant les données tensorielles via multicast à plusieurs unités de calcul simultanément.
Autre point fondamental : CDNA 5 passe à l’exécution native Wave32, connue dans les cartes grand public RDNA, et abandonne définitivement Wave64. Là où une instruction nécessitait auparavant quatre cycles pour traverser un SIMD de seize voies de large, le MI455X lance une nouvelle instruction à chaque cycle sur une unité de 32 voies de large. Cela réduit la latence des instructions et la pénalité sur le code de branchement.
De plus, la puce prend en charge la norme complète OCP MX pour les formats de données à mise à l’échelle par blocs, y compris la mise à l’échelle fractionnaire qui rend l’entraînement FP4 pratiquement utilisable en réduisant les erreurs de quantification.
Les chiffres
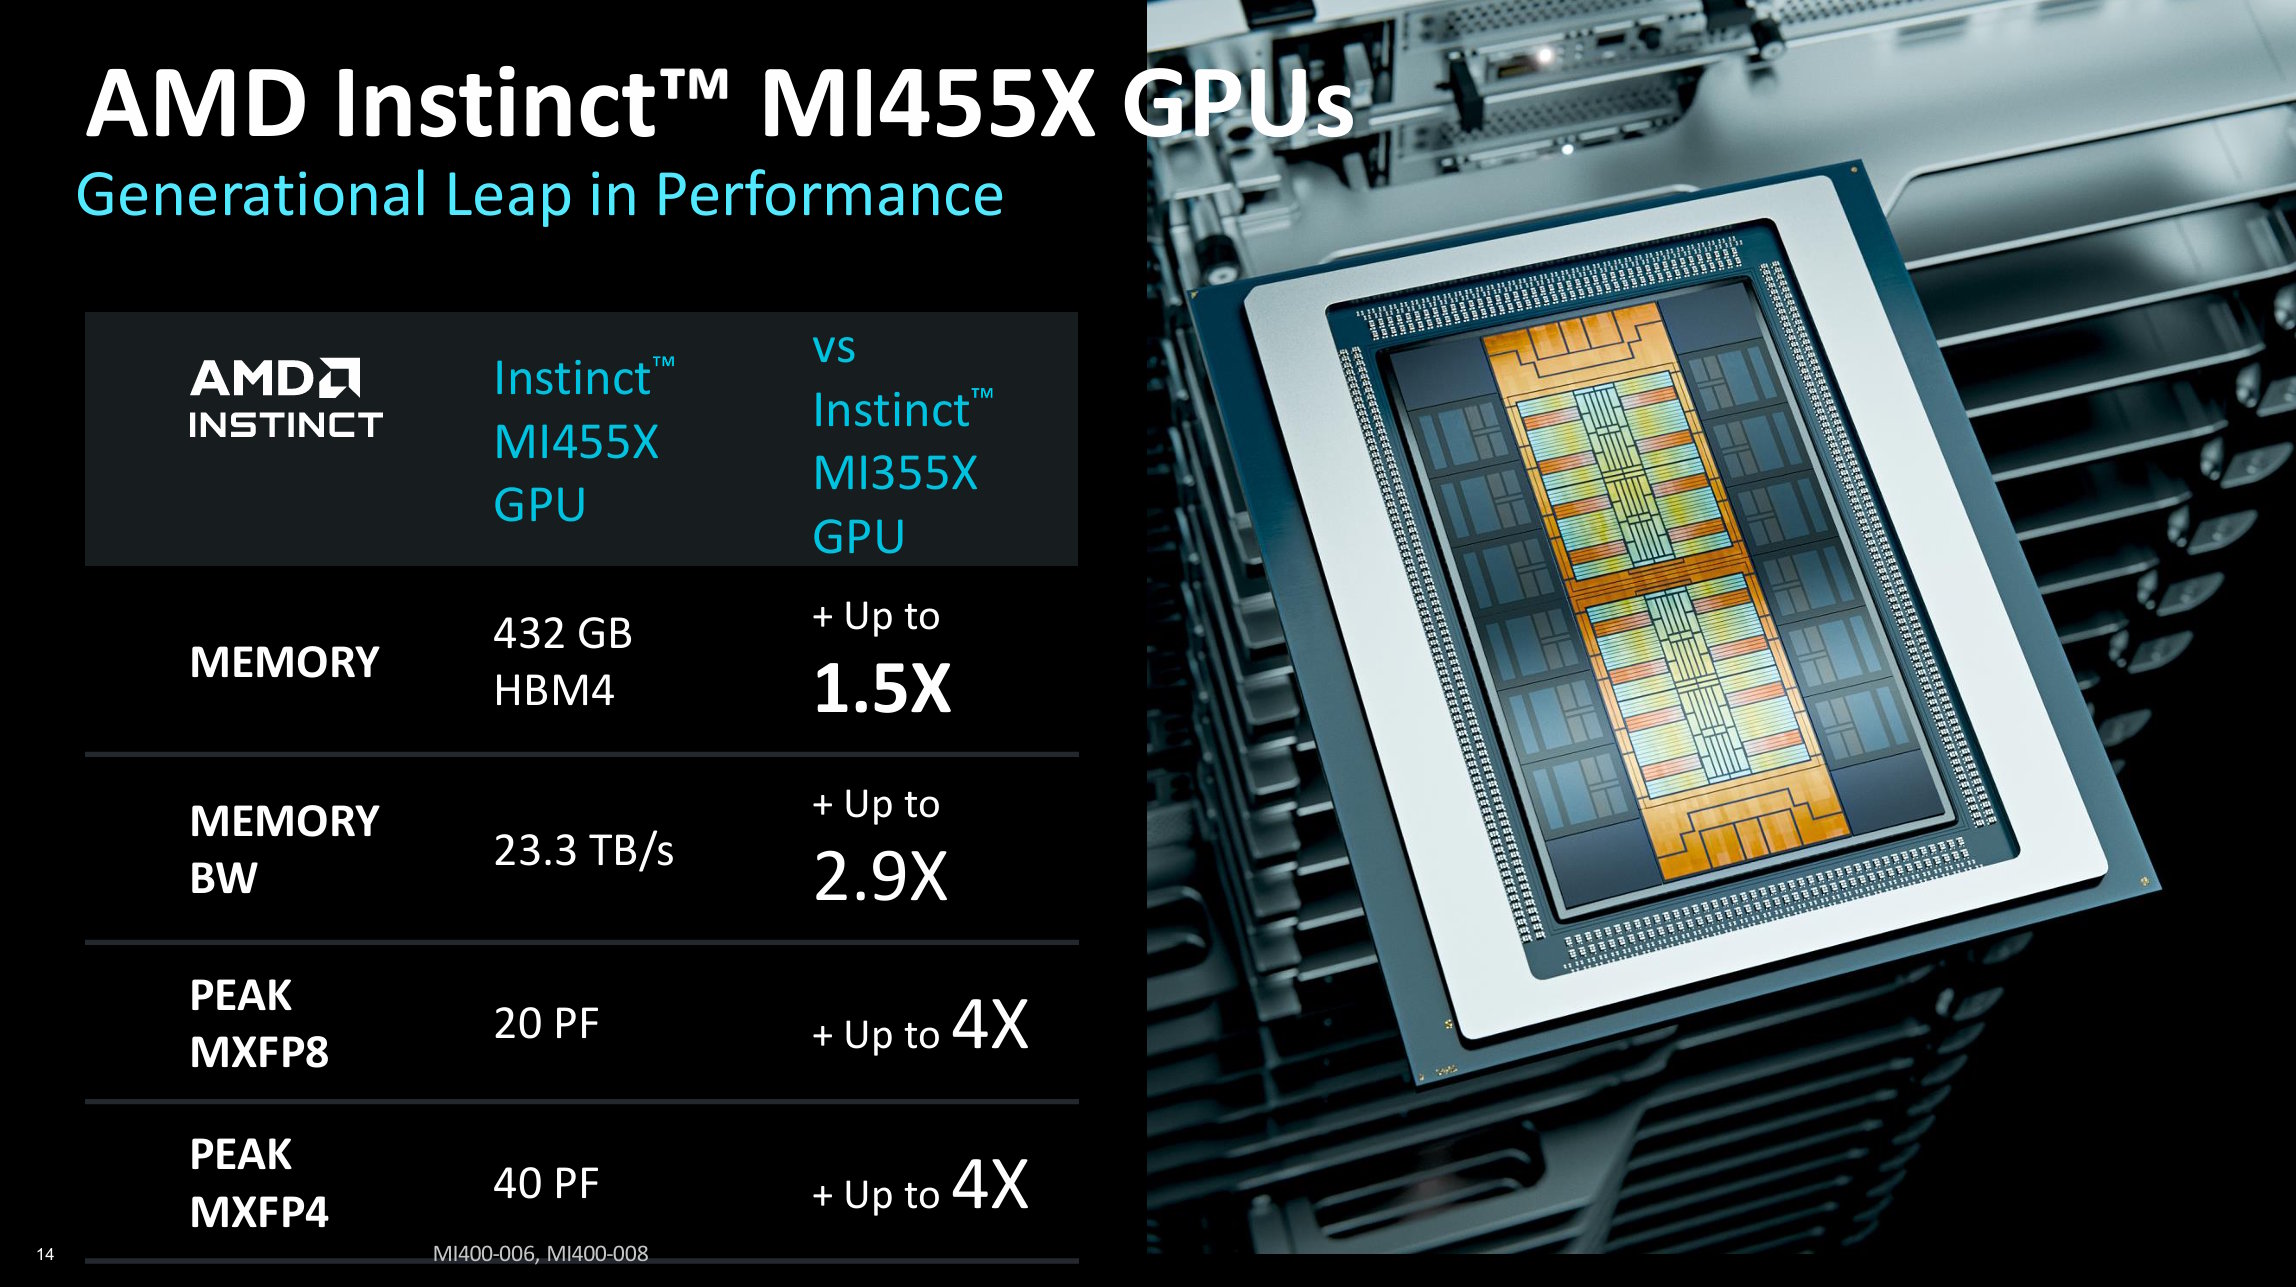
| Spécification | Instinct MI455X | Par rapport à l’Instinct MI355X |
| Procédé | 2 nm (TSMC), chiplets | — |
| Transistors | 320 milliards | — |
| Mémoire | 432 Go HBM4 (12 piles) | Jusqu’à 1,5x plus |
| Bande passante mémoire | 23,3 To/s | Jusqu’à 2,9x plus |
| Pic MXFP4 | 40,26 pétaflops | Jusqu’à 4x plus |
| Pic MXFP8/FP8 | 20,13 pétaflops | Jusqu’à 4x plus |
| Pic MXFP6 | 20,13 pétaflops | Jusqu’à 2x plus |
| Matrice FP16/BF16 | 5,03 pétaflops | Jusqu’à 2x plus |
| Cache L2 | 2x 96 Mo partagés globalement | Nouvelle hiérarchie de cache |
| Bande passante scale-up | 3,6 To/s par GPU (UALoE) | — |
Selon AMD, ces spécifications se traduisent par un débit de jetons (tokens) jusqu’à 34 fois supérieur et des coûts par jeton jusqu’à dix-huit fois inférieurs à ceux de l’Instinct MI355X, mesurés sur DeepSeek V4 Flash avec FP4. Fait notable : lors du briefing, le responsable logiciel Anush Elangovan a souligné que les chiffres clés, 20 pétaflops FP4 et 20 To/s de bande passante HBM, sont des valeurs mesurées sur du matériel fonctionnant dans le laboratoire d’AMD, et non des projections.
L’efficacité avant la puissance brute
Montrer ses muscles est une chose, mais les innovations les plus intéressantes résident dans leur utilisation. « Nous devons optimiser simultanément le calcul, la mémoire, la communication, l’efficacité énergétique et le coût », explique Smith. Le MI455X reçoit pour cela un arsenal de nouvelles techniques : un Tensor Data Mover qui fait chevaucher les transferts de mémoire avec le travail de calcul, des clusters de groupes de travail qui donnent aux programmeurs le contrôle sur le placement des données, des barrières fractionnées pour une synchronisation plus efficace, et une latence de démarrage du noyau (kernel) nettement plus faible pour que même les noyaux courts maintiennent la machine occupée.
L’architecture DMA entièrement retravaillée répartit automatiquement les transferts de données sur les connexions disponibles, en tenant compte de la congestion du réseau.
Plus près des cœurs de calcul, tout évolue également avec les exigences des modèles modernes. Le stockage de données local par processeur de groupe de travail double en capacité et en bande passante, et un thread peut désormais accéder à jusqu’à 1 024 registres au lieu de 256, ce qui est nécessaire pour maintenir les unités vectorielles plus larges occupées.
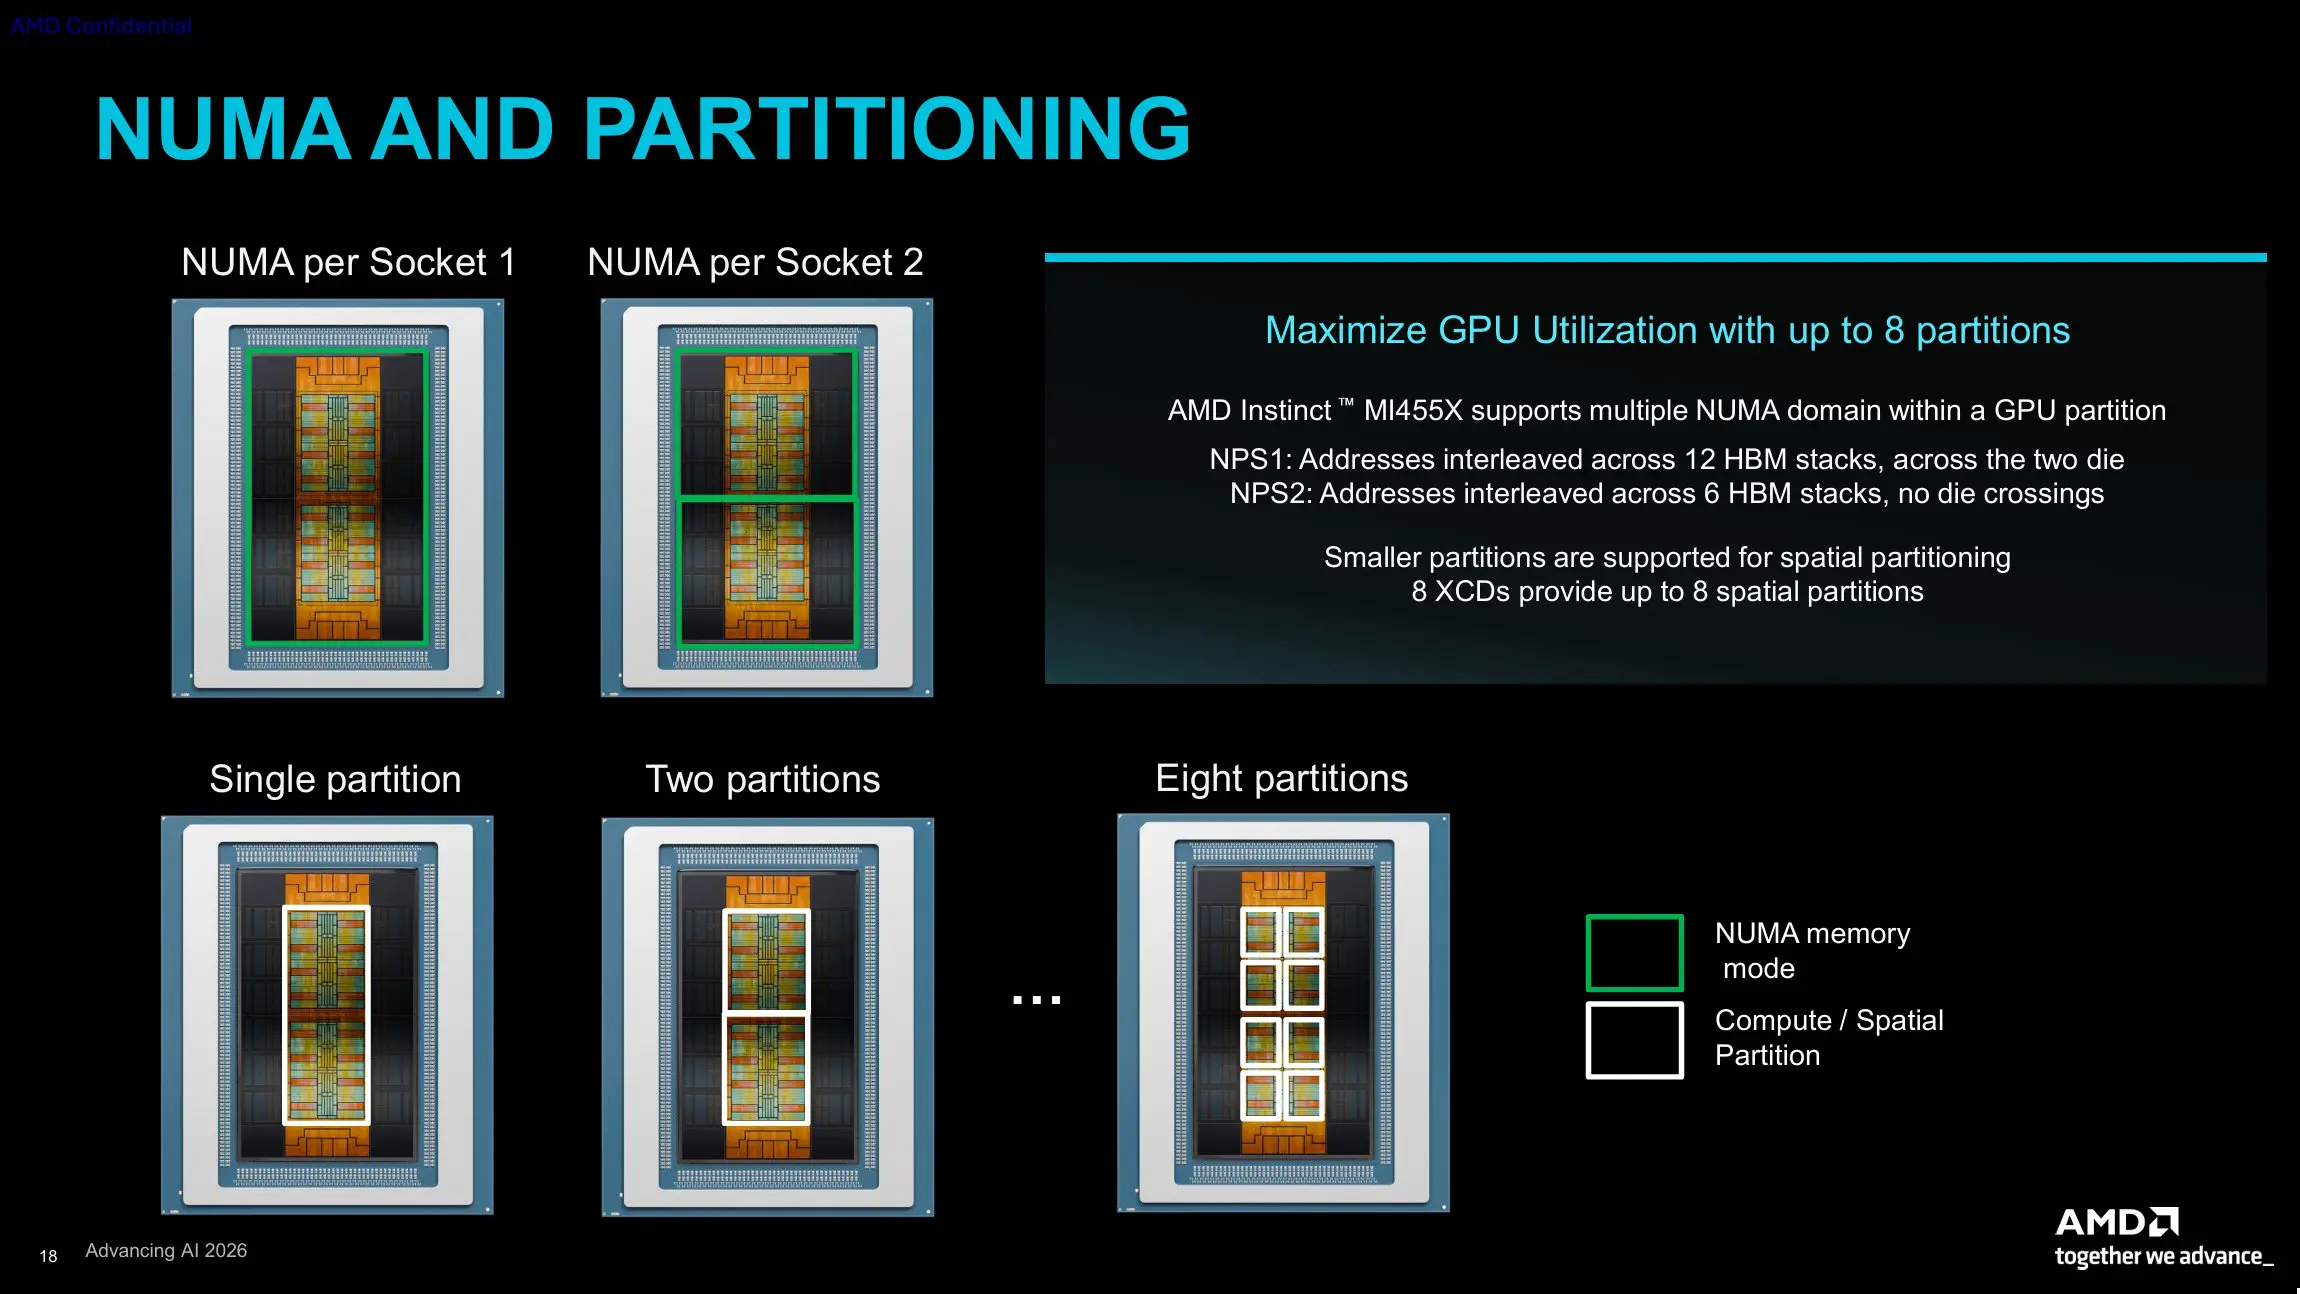
Pour plus de flexibilité, le MI455X prend en charge différents modes NUMA : faire fonctionner le GPU comme un seul grand domaine de mémoire, le diviser en deux, ou le partitionner en un maximum de huit GPU virtuels plus petits pour les environnements virtualisés.
La sécurité s’adapte également de la puce au rack : une racine de confiance matérielle et l’informatique confidentielle protègent les poids des modèles, les invites (prompts) et les caches KV pendant l’exécution, et grâce aux pods virtuels au sein d’AMD Helios, les locataires restent totalement isolés les uns des autres.
Deux variantes : MI455X et MI430X
La série MI400 se compose au lancement de deux membres ayant chacun leur public cible.
| Instinct MI455X | Instinct MI430X | |
| Groupe cible | IA de pointe (Frontier-AI) et usines d’IA | IA souveraine et HPC |
| Déploiement | AMD Helios à l’échelle du rack (72 GPU par rack) | Clusters HPC classiques basés sur un maillage |
| Force | Jusqu’à 40 PF FP4, débit de jetons maximal | Jusqu’à 288 TFLOPS FP64 matériel |
| Mémoire | 432 Go HBM4 | HBM4 |
Avec le MI430X, AMD joue son vieil atout HPC : là où la concurrence a largement abandonné le FP64 matériel, AMD combine, grâce à son approche par chiplets, la puissance de calcul de l’IA en FP4 avec une double précision complète pour le calcul scientifique. Cela rend la carte idéale pour les institutions de recherche qui font tourner l’IA et la simulation sur la même infrastructure.
Le moteur d’Helios
Le MI455X est expressément conçu comme le moteur d’AMD Helios, le système à l’échelle du rack qu’AMD lance simultanément. Dans ce système, 72 MI455X collaborent avec un processeur Epyc Venice SP7 pour quatre GPU, qui rejoint le domaine de mémoire via Infinity Fabric cohérent à 256 Go/s par GPU au lieu de servir de simple hôte PCIe.
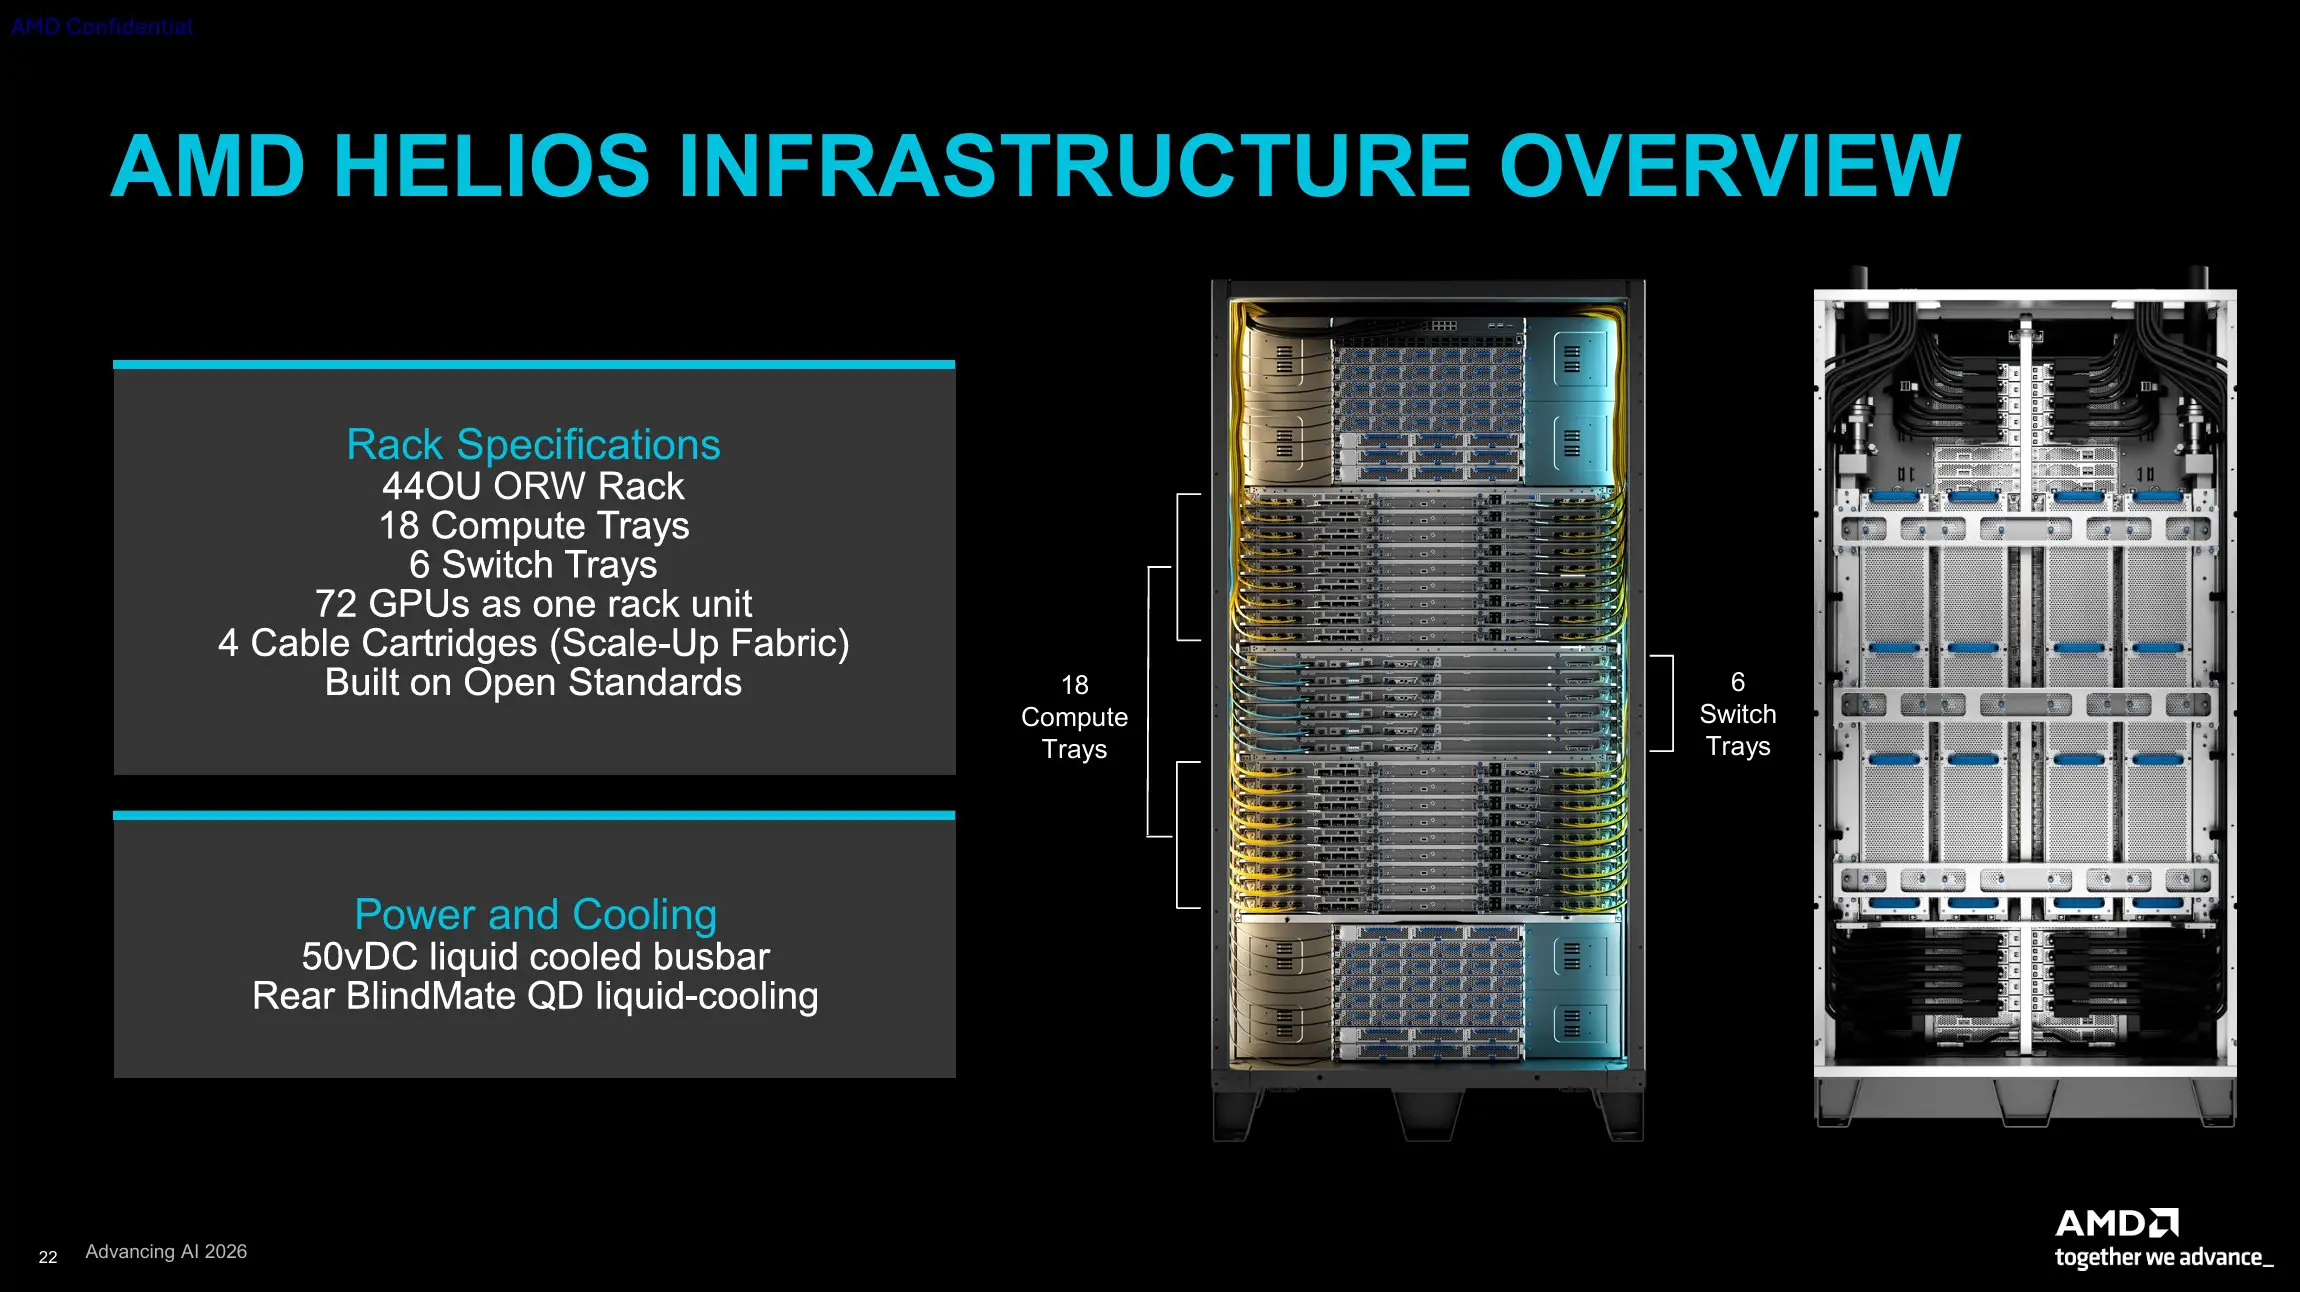
Chaque GPU dispose de 3,6 To/s de bande passante scale-up via UALink sur Ethernet et d’un emplacement pour trois cartes réseau 800G pour le scale-out. Au total, cela donne un rack avec 31 To de HBM4, 2,9 exaflops de puissance de calcul FP4 et 260 To/s de bande passante interne, où chaque GPU atteint n’importe quel autre GPU en un seul bond.
Et Nvidia ?
La barre est évidemment fixée par le Vera Rubin NVL72 de Nvidia, annoncé au CES et prévu, tout comme Helios, pour le second semestre. AMD revendique sur le papier 15 % de calcul FP4 en plus, 50 % de mémoire HBM en plus et jusqu’à 30 % de jetons en plus par dollar ; sur la bande passante scale-up, les deux racks terminent à égalité avec 260 To/s.
Cette comparaison mérite toutefois une nuance : AMD oppose ses propres mesures et modèles aux spécifications publiées d’un rack qui n’est pas encore chez les clients, tandis que Nvidia promet de son côté cinq fois les performances d’inférence de Blackwell et des coûts de jetons dix fois inférieurs. Le papier est pour l’instant patient, des deux côtés.
De plus, le véritable rempart de Nvidia reste le logiciel. Le dirigeant d’AMD Andrew Dieckmann a beau qualifier CUDA de « non-événement » lors du briefing, c’est pourtant AMD qui parle de son plus grand handicap : le gros de l’outillage IA, de la documentation et des développeurs vit toujours dans l’écosystème de Nvidia, et Vera Rubin s’adresse à une base de clients qui tourne déjà aujourd’hui sur Blackwell.
AMD admet d’ailleurs lui-même que les comparaisons entre fournisseurs de GPU sont surtout des instantanés de l’état d’avancement de leurs logiciels respectifs. Une vérité qui peut tout aussi bien se retourner contre lui dès que Nvidia mettra à jour sa pile logicielle.
La feuille de route est désormais fixée : la série MI500 suivra en 2027 avec la prochaine génération de HBM et un domaine de scale-up plus vaste avec des interconnexions en cuivre et optiques, tandis que le MI600 est déjà en développement. Plus important encore : avec OpenAI, Meta, Anthropic, Microsoft et Oracle, les plus gros acheteurs de GPU au monde mettent pour la première fois en place des gigawatts d’alternatives à Nvidia.
Le MI455X n’a pas besoin de battre Vera Rubin sur tous les fronts pour cela ; il doit surtout prouver que le deuxième fournisseur est enfin mature. Sur le papier, cette preuve est faite, elle devra se concrétiser dans des centres de données opérationnels au second semestre.