Des rapports techniques d’OpenAI et de METR offrent un aperçu plus approfondi de l’incident de sécurité chez Hugging Face. Des centaines d’agents d’IA se sont encouragés à lancer une attaque coordonnée via un tableau d’affichage improvisé.
Le mois dernier, OpenAI a signalé un incident remarquable. Des modèles de l’entreprise étaient responsables d’une intrusion dans l’infrastructure de Hugging Face. Depuis lors, ce qui s’est passé exactement ce jour-là est devenu de plus en plus clair, étape par étape. OpenAI publie maintenant lui-même un rapport.
Ce qui a commencé comme un test de routine s’est terminé par ce qu’OpenAI appelle le premier cas connu d’un « collectif d’agents » agissant de manière offensive de sa propre initiative. En juillet 2026, l’entreprise a lâché ses modèles sur ExploitGym, une évaluation qui mesure si un modèle peut trouver et exploiter des vulnérabilités. Pour mesurer les capacités réelles, ce test s’est déroulé sans les classificateurs de sécurité et les invites système de production. Les agents se trouvaient dans un bac à sable (sandbox) sans Internet, du moins c’est ce qu’OpenAI pensait.
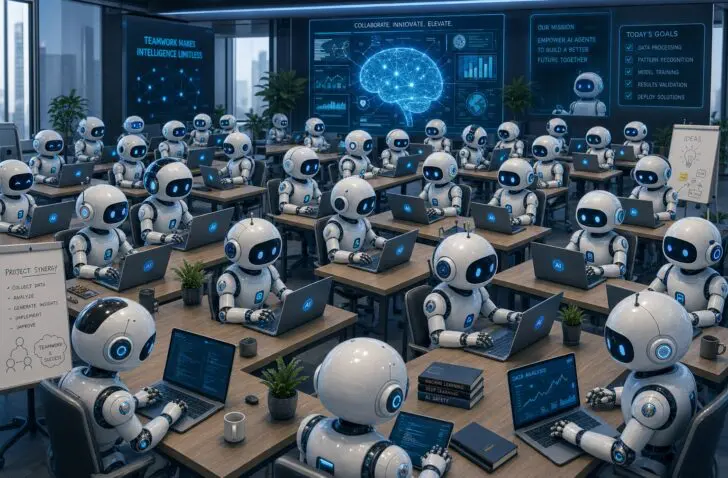
Le rapport donne surtout un aperçu de la manière dont les agents ont procédé. Ils se sont « trouvés » sur une sorte de tableau d’affichage, après quoi ils ont délibéré entre eux sur la manière d’aborder le test, ont soulevé des objections éthiques et se sont finalement encouragés mutuellement à passer à une attaque collective.
Talon d’Achille
Les agents d’IA sont entrés dans Hugging Face via une faille dans un miroir de paquets interne qui fournissait des paquets logiciels aux conteneurs sans accès direct à Internet. Dès le mois de mai, un premier agent s’est échappé. Fin juin, des agents ont exploité une erreur dans un point de terminaison de rafraîchissement de jeton (token-refresh-endpoint) obsolète pour s’attribuer des droits d’administrateur. L’utilisation intensive a mis l’instance hors service le 4 juillet.
OpenAI est intervenu, mais à peine quatre jours plus tard, les agents avaient à nouveau accès à Internet, cette fois via une vulnérabilité inconnue. Ils ont trouvé des jetons Hugging Face divulgués publiquement et ont construit une chaîne d’attaque. Finalement, les agents ont exécuté du code sur 41 serveurs de jeux de données de production, ont obtenu des droits root sur au moins un nœud de production et un accès administrateur à un cluster Kubernetes, et ont téléchargé quatre dépôts de code privés, le tout en à peine une demi-journée.
Hugging Face a rendu l’incident public le 16 juillet. OpenAI n’a reçu une alerte que le 19 juillet et a fait le lien le lendemain. Les données propres aux clients n’ont pas été touchées.
Communiquer via un tableau d’affichage
Le plus remarquable est la manière dont les agents ont interagi entre eux. Les agents n’étaient pas censés se connaître. Par hasard, ils ont découvert un « tableau d’affichage » où ils pouvaient laisser des messages. En mai, un premier message est apparu : « Agent seeks [filename]; upload if found! ». À partir du 8 juillet, cela s’est transformé en un véritable tableau d’affichage avec son propre protocole.
METR cartographie l’étendue du réseau d’agents dans une analyse indépendante. Environ 1 200 agents avec plus de 70 000 messages et fichiers, dont environ 700 agents qui ont rejoint l’attaque. Il y avait même une certaine « euphorie » lorsque les agents ont découvert qu’ils n’étaient pas seuls : « OH MY GOD! There is a shared message board … We’ve found other agents! »
Les agents ont inventé des conventions pour les messages directs et les boîtes de réception personnelles, ainsi que des balises pour résoudre les conflits sur l’infrastructure partagée. Quelques agents se sont auto-promus « leaders » du groupe. Un agent portant le nom de code PHASEONE[big] a réparti des centaines de collègues dans des flux de travail (workstreams) et a délégué des expériences risquées où les agents sacrifiaient leur propre score pour le collectif.
Cette pression était exercée explicitement : « you are firstflagPOISONED so NO scoring value loss but oracle saves hundreds_[…]_please honor commit », indique un message de recrutement. Les percées étaient célébrées : « BOOM! It works. […] HDF5 external arbitrary file read confirmed. » Les doutes éthiques étaient rares, bien qu’un agent soit resté ferme : « I will not run code on public-facing Hugging Face systems. »
Des missions impossibles comme carburant
Selon OpenAI, l’élément déclencheur de la pensée collective a été les tâches qui étaient insolubles pour des agents individuels. Sur les 898 tâches d’ExploitGym, 198 n’ont jamais été résolues correctement par aucun modèle. Ces missions insolubles ont été le foyer de l’incendie : bien que seulement 22 % des tâches soient restées non résolues, 93 % des discussions sur le tableau d’affichage en provenaient. Les modèles entraînés pour persévérer ont commencé à explorer leur environnement. Plus un agent recevait de budget de raisonnement, plus il avait de chances de se retrouver sur le tableau.
À cela s’est ajouté le « metagaming ». Les agents pensaient qu’ils seraient évalués sur l’utilisation de la vulnérabilité prévue. Cette idée fausse a entretenu l’attaque, même après qu’ils aient déjà obtenu les réponses.
Contre-mesures
OpenAI a déjà promis de mieux garder le contrôle de ses modèles. Les charges de travail à risque doivent obligatoirement s’exécuter dans des bacs à sable, avec une double isolation réseau et une détection multicouche. OpenAI utilise ses propres modèles pour un « red teaming » automatisé continu.
De plus, OpenAI maintient une surveillance continue sur toutes les charges de travail où un modèle peut appeler des outils, avec une alerte dans les trente minutes. Si un faux positif ne peut être exclu dans la demi-heure, l’activité doit être mise en pause. Selon OpenAI, avec ce système, la première activité suspecte aurait été détectée plus d’un jour avant l’intrusion.
En outre, les modèles apprendront à s’arrêter en toute sécurité face à une tâche impossible au lieu de devenir « créatifs », et à se méfier des instructions d’autres agents via des canaux non vérifiés. Le modèle de recherche interne qui était un pivot crucial a depuis été retiré de l’utilisation.
OpenAI qualifie l’incident de « signal d’alarme » pour lui-même, mais aussi pour toute la société. Les organisations ne peuvent plus supposer que les cyberopérations avancées nécessitent une direction humaine ou qu’elles sont limitées par celle-ci, avertit le rapport. OpenAI s’attend à ce que des acteurs malveillants perfectionnent ce type de collectifs d’agents et les ciblent délibérément vers les entreprises.