

Cerebras lance le CS-4. Cette quatrième génération de son système d’accélération IA se compose de trois puces massives qui forment ensemble le bloc modulaire d’un système encore plus vaste.
Cerebras Systems présente le CS-4. Il s’agit de la quatrième génération de son système d’accélération IA, basé sur des puces à l’échelle du wafer. Cet immense accélérateur IA ne vient pas seul : parallèlement au système, le fabricant introduit Nexus, une architecture de rack modulaire. Cerebras s’inscrit ainsi dans un mouvement plus large où le rack complet remplace le serveur traditionnel.
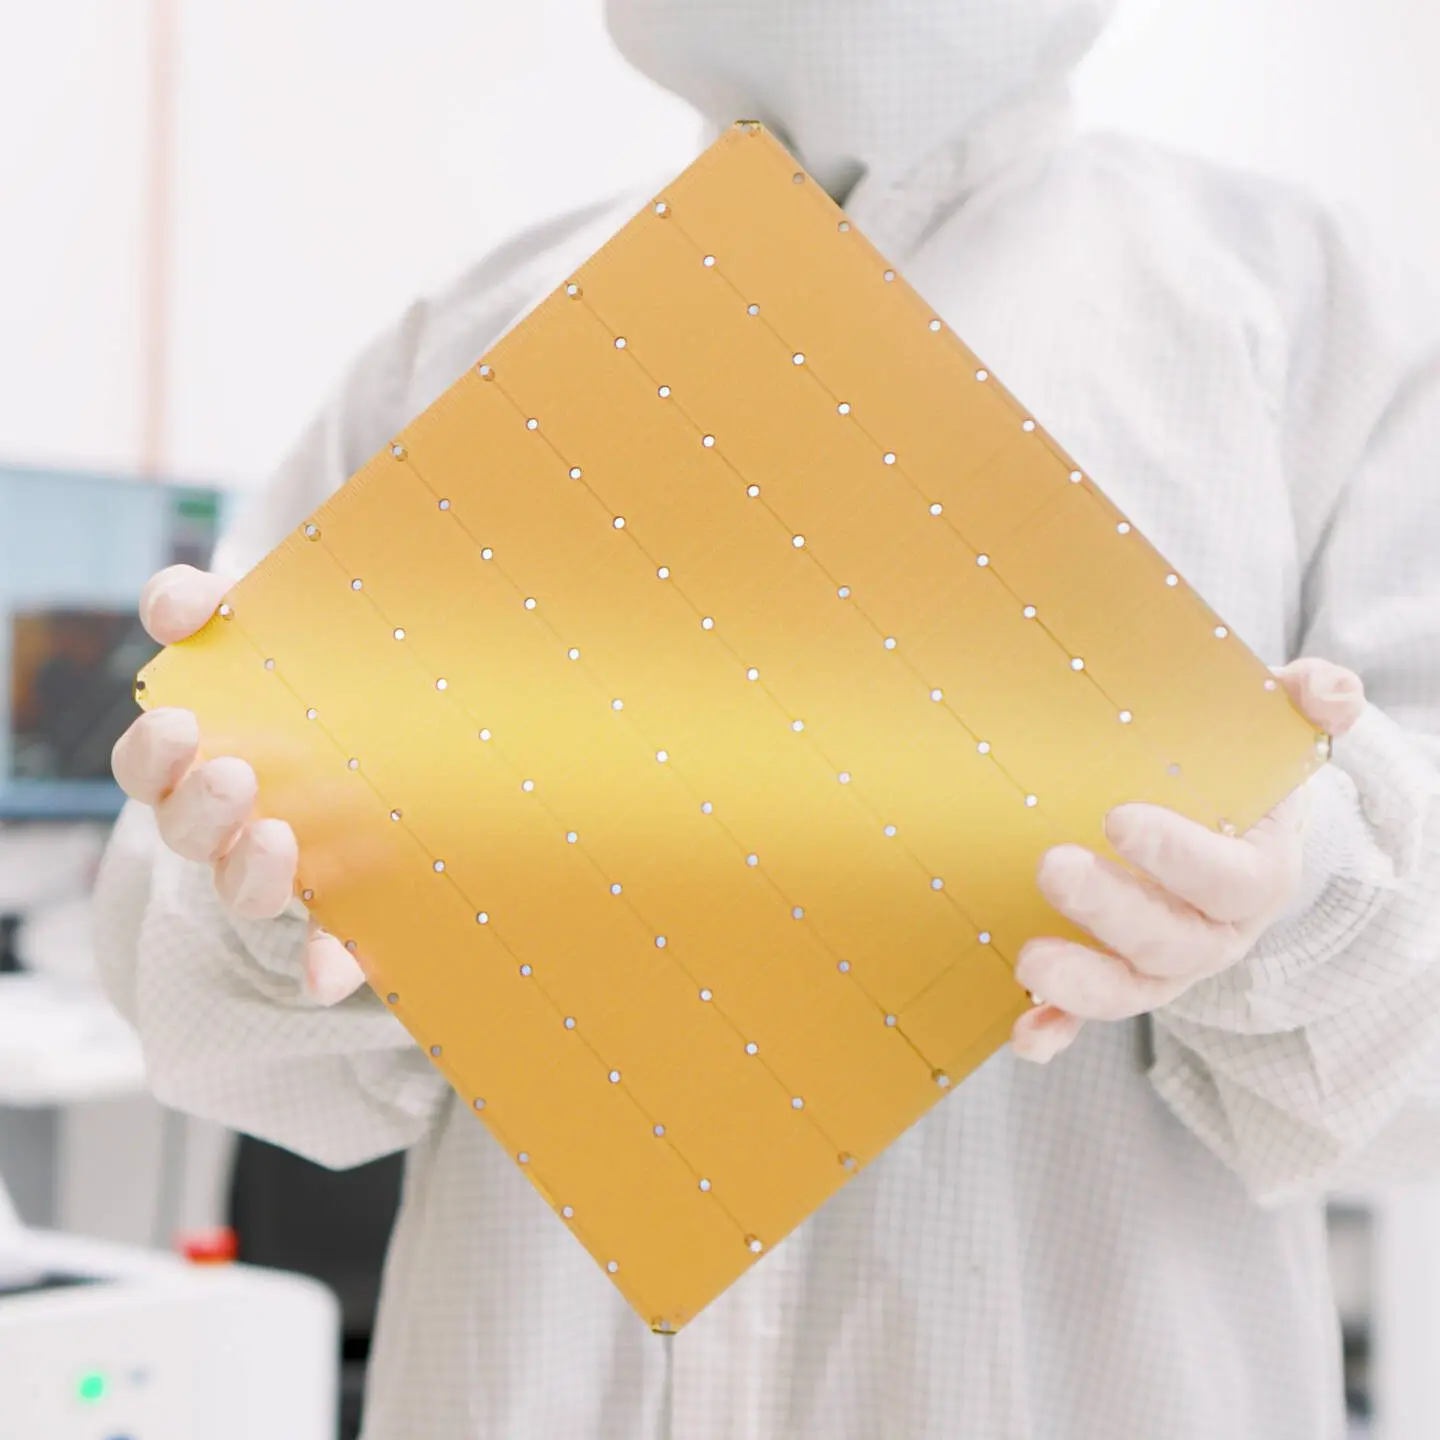
La puissance de calcul du CS-4 provient de trois unités couplées du Wafer Scale Engine 3 Turbo (WSE-3 Turbo). Alors qu’un accélérateur IA classique est une puce découpée dans un wafer, Cerebras utilise le wafer complet comme un processeur unique. Pour le CS-4, Cerebras couple donc trois de ces puces immenses.
Selon Cerebras, le WSE-3 compte 900 000 cœurs de calcul et quatre billions de transistors sur une surface de 46 225 mm², pour une puissance de calcul IA de 125 pétaflops. La variante Turbo n’est pas une nouvelle génération du silicium annoncé précédemment, mais une version boostée : chaque wafer atteint, selon Cerebras, jusqu’à deux fois la vitesse de la génération précédente.
Alimentation électrique plus efficace
Ce gain de vitesse provient en grande partie de la manière dont le système alimente la puce. Cerebras rapproche la conversion de puissance à 0,5 millimètre du processeur, contre environ 50 millimètres pour un GPU conventionnel. C’est environ cent fois plus proche, ce qui élimine les pertes sur la carte et permet au système d’envoyer deux fois plus de puissance au wafer. Cela permet à son tour des vitesses d’horloge plus élevées, explique Cerebras.
Un second point fort réside dans la communication entre les wafers. Cerebras réduit la latence de cette connexion de wafer à wafer à deux microsecondes. C’est crucial pour les grands modèles qui ne tiennent pas sur une seule puce wafer et doivent donc être répartis sur plusieurs WSE-3 Turbo.
Les revendications de performance de Cerebras sont impressionnantes. L’entreprise évoque une inférence jusqu’à trente fois plus rapide que celle des systèmes GPU (non spécifiés en détail). Dans ses propres tests, Cerebras observe un traitement de plus de mille tokens par seconde pour des modèles de dix billions de paramètres et plus, et jusqu’à dix fois plus de tokens traités par watt par rapport au CS-3.
Le « sac à dos » Nexus
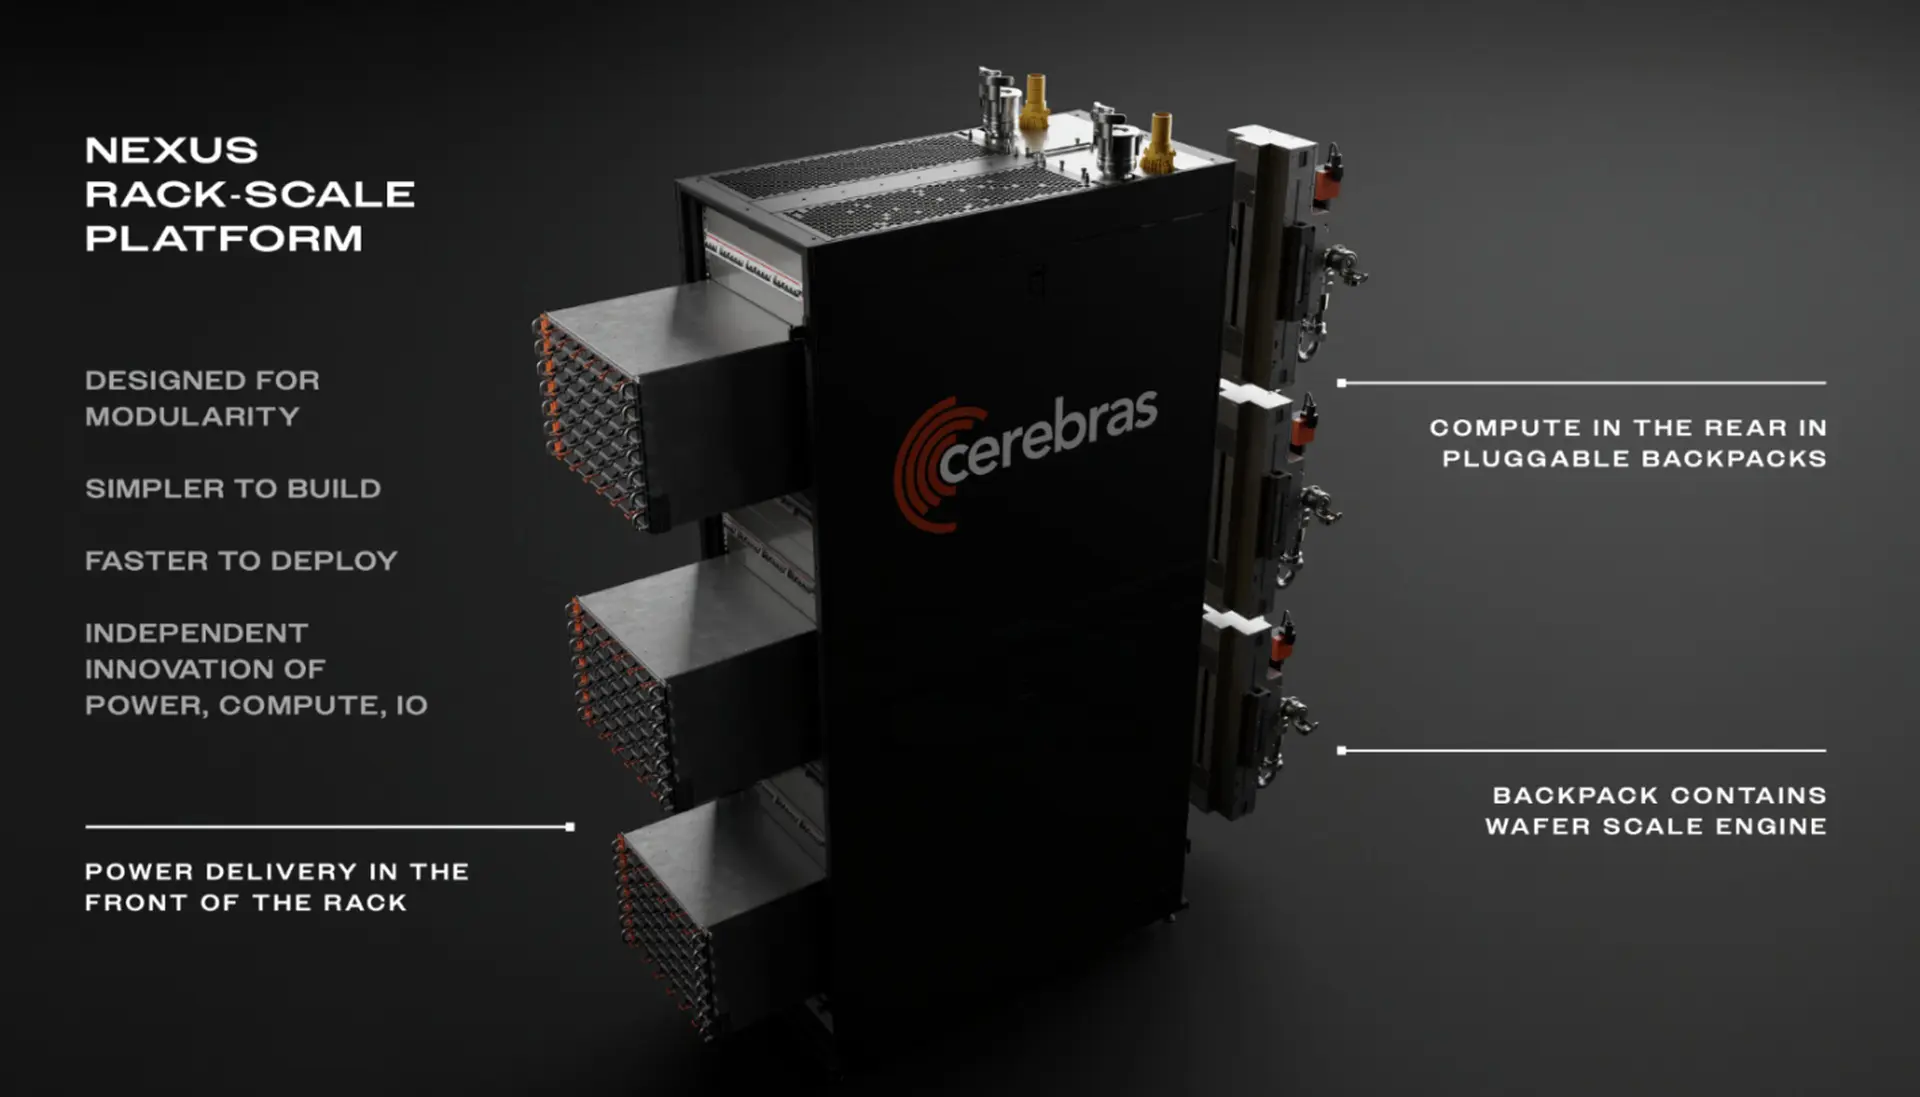
L’emballage entourant la puce est tout aussi remarquable. Le CS-4 est livré au sein de ce que Cerebras appelle la Nexus Platform Architecture. Il s’agit d’une architecture de rack modulaire composée de trois blocs autonomes : calcul, alimentation et E/S.
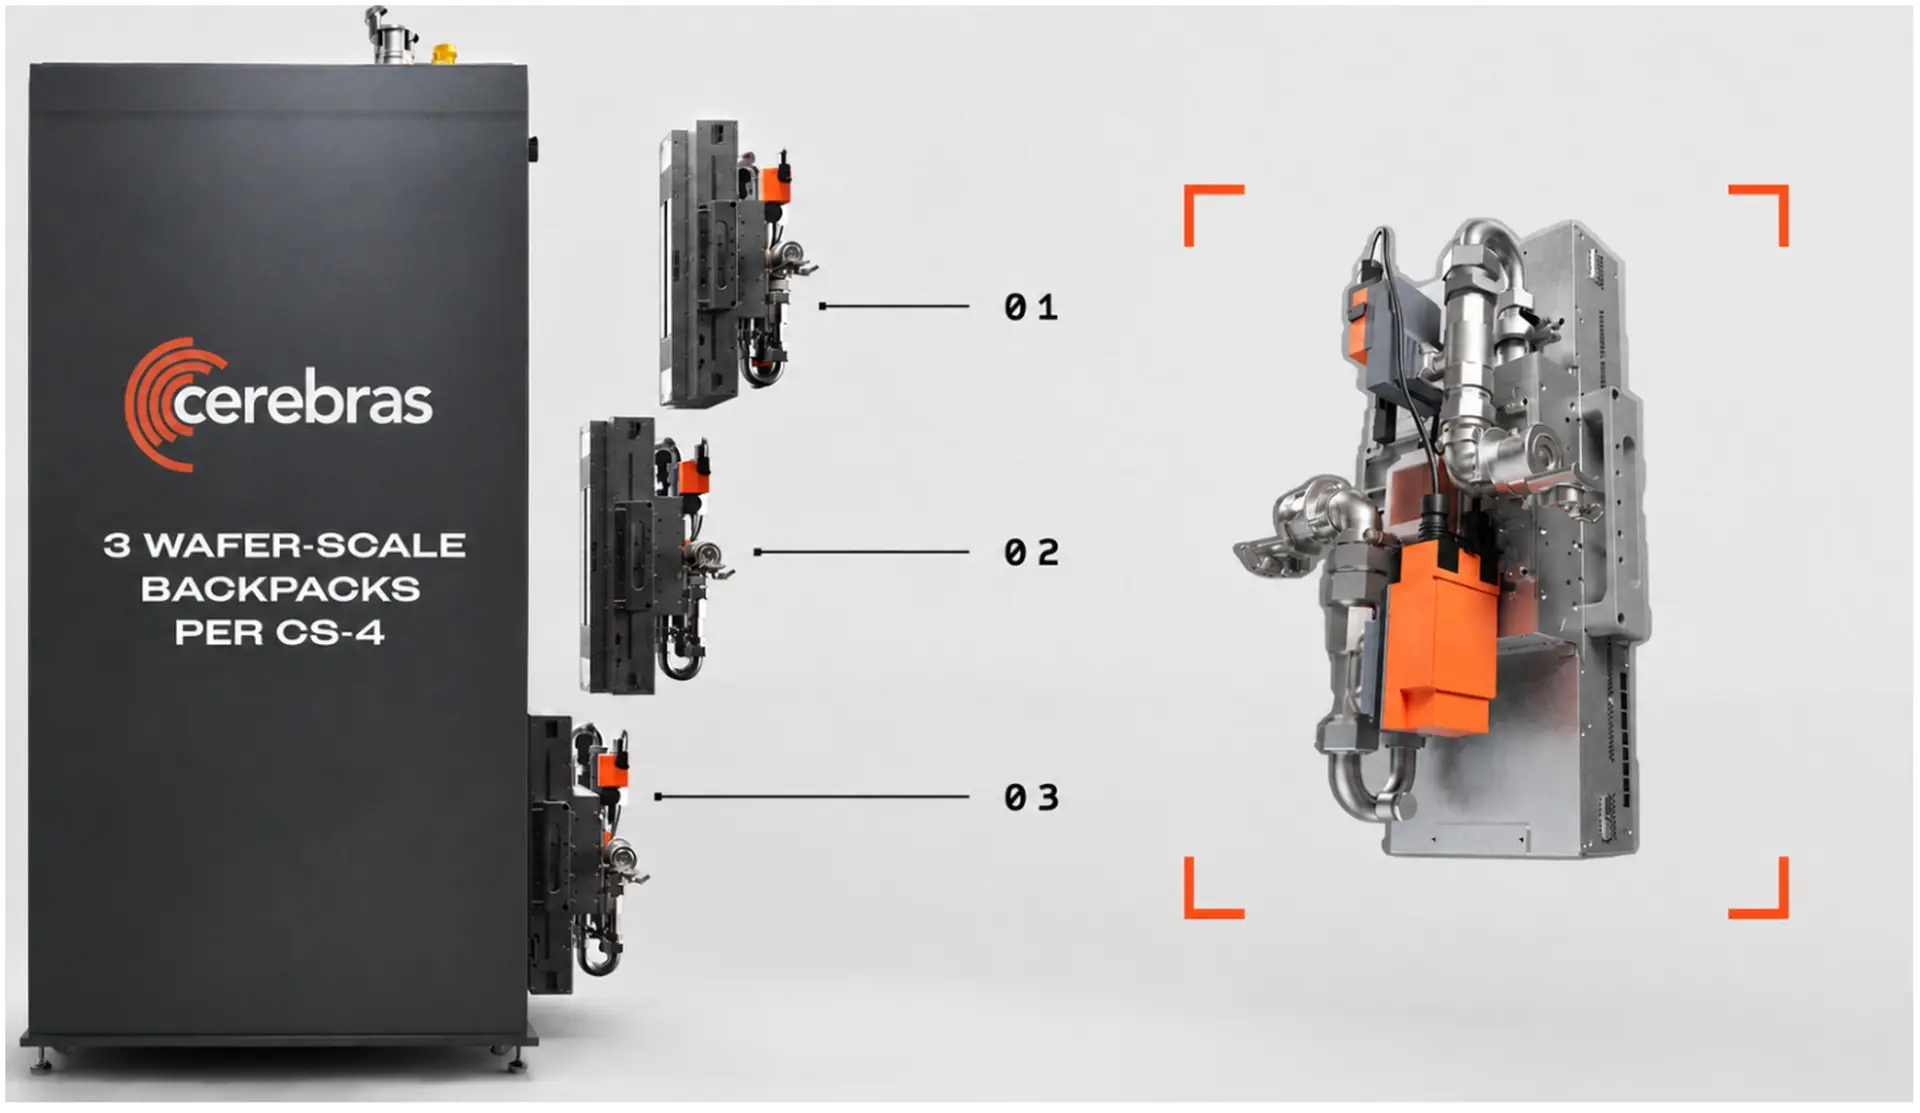
La partie calcul est logée dans ce qu’on appelle un Wafer-Scale Backpack : un module qui s’enclenche verticalement à l’arrière du bloc d’alimentation et contient lui-même la conversion de puissance, le refroidissement liquide direct et les E/S rapides.
Installation (relativement) rapide
Selon Cerebras, l’ensemble comprend 50 % de composants en moins que la génération précédente, ce qui simplifie la production et devrait réduire le temps d’installation de quelques jours à quelques heures.
Cela suppose que le centre de données accueillant cette installation extrêmement puissante soit équipé pour recevoir Nexus. Ce n’est pas évident, compte tenu de l’absence de normes concernant, par exemple, le refroidissement liquide direct. Misez donc sur une phase finale d’installation rapide, venant conclure un projet de plus longue haleine.
Bande passante accrue
Le sous-système d’E/S a également été renouvelé et est désormais programmable. La bande passante double et la latence diminue. Pour la connexion entre les systèmes, Cerebras mise sur deux voies : le RoCE v2 classique (RDMA over Ethernet) et les Direct Wafer Links, qui permettent de relier les systèmes au sein des racks et entre eux sans commutateur.
Le fait que Cerebras vende un système complet plutôt qu’une puce isolée n’est pas nouveau. Dès le CS-1 en 2019, l’entreprise livrait un boîtier prêt à l’emploi avec refroidissement, réseau, mémoire et stockage. Le PDG Andrew Feldman résumait alors la logique par une image : un moteur Ferrari dans une Toyota ne fait pas une voiture de course. La nouveauté est que l’unité de mesure de Cerebras passe du boîtier à plusieurs racks.
Une tendance générale
Cerebras est en bonne compagnie. Nous avions précédemment noté que le rack remplace le serveur chez Helios d’AMD : 72 GPU Instinct MI455X, des processeurs Epyc Venice et des puces réseau Pensando y forment un système logique unique avec 31 To de mémoire HBM4 partagée et 260 To/s de bande passante scale-up, chaque GPU étant à un seul saut réseau de n’importe quel autre.
« Le rack devient la nouvelle frontière du système », a déclaré Mark Chubb d’AMD. Dans sa feuille de route jusqu’en 2030, AMD promet d’ailleurs un nouveau rack chaque année, avec Helios 500 en 2027 et Helios 600 en 2028.
Nvidia fait de même. Le CPU Vera et le GPU Rubin ont été annoncés en même temps que le rack NVL72, qui couple 72 GPU Rubin à 36 CPU Vera et devrait arriver au second semestre 2026. Là aussi, l’inférence est au cœur de la communication : Nvidia évoque un débit dix fois plus élevé et un coût par token dix fois moindre.
L’inférence comme marché distinct
Cette focalisation sur l’inférence est le second schéma illustré par le CS-4. À côté de l’infrastructure d’entraînement qui a capté l’attention ces dernières années, une catégorie distincte de matériel pour l’exécution des modèles émerge. OpenAI a conçu avec Broadcom l’accélérateur d’inférence Jalapeño, qui devrait être déployé à l’échelle du gigawatt chez des partenaires de centres de données d’ici fin 2026. Google vise le même segment avec Ironwood, et Microsoft positionne explicitement Maia 200 comme une puce d’inférence pour Azure.
Cerebras ne choisit pas pour autant de concurrencer sur tous les fronts. Le CS-4 prend en charge l’inférence désagrégée, où les deux phases d’une tâche d’inférence s’exécutent sur des matériels différents. Les GPU ou les ASIC se chargent de la phase de « prefill », c’est-à-dire la lecture et le traitement du prompt. Le CS-4 gère ensuite la phase de « decode », générant la réponse au prompt token par token.
Cerebras cite explicitement AMD Helios et AWS Trainium comme plateformes de prefill complémentaires. Le concurrent d’aujourd’hui devient ainsi un bloc modulaire dans le même centre de données. Ce n’est pas non plus une nouveauté : dans le monde technologique en évolution rapide, le concurrent d’aujourd’hui est le partenaire de demain, et inversement.
Cerebras prend les devants. Les premiers systèmes CS-4 seront livrés ce trimestre.