

Construire des superordinateurs est aujourd’hui plus complexe que jamais : la technologie évolue plus vite que les équipes chargées de les déployer et de les gérer. HPE avertit que le succès ne dépend pas uniquement des GPU et de la capacité de calcul, mais aussi des personnes, des processus, du refroidissement, de la conformité et d’une architecture de services réfléchie. Nous jetons un coup d’œil dans les coulisses de HPE Discover Barcelona 2025.
Quiconque souhaite aujourd’hui mettre en place un superordinateur ou une plateforme HPC (High Performance Computing) à grande échelle s’engage dans un parcours qui va bien au-delà de la commande de quelques racks de GPU. La vision classique — empiler du matériel, connecter le réseau et soumettre des tâches — est définitivement révolue. À la place, les superordinateurs ont évolué vers des usines d’IA : des écosystèmes complexes dans lesquels le calcul, le stockage, le réseau, le refroidissement, la sécurité, la conformité et l’humain doivent collaborer de manière fluide.
Lors de HPE Discover à Barcelone, Chris Davidson, responsable HPC et IA chez HPE, explique pourquoi cette tâche est si ardue. Ce qui ressort de l’entretien : le risque majeur n’est pas une défaillance technologique, mais le fait que les organisations sous-estiment tout ce qui doit être mis en œuvre autour de cette technologie.
« Il ne s’agit pas d’un seul produit, mais de l’union de la technologie et de l’humain pour former une solution opérationnelle. »
Selon Davidson, HPE ne considère plus les superordinateurs comme de simples machines, mais comme des solutions complètes. Une plateforme HPC ne se compose pas seulement de serveurs GPU, mais aussi de réseaux haute performance, de stockage spécialisé, de refroidissement avancé, d’une couche d’orchestration et de gestion, ainsi que d’un ensemble solide de services.
Ces services vont de la conception et de l’implémentation au support à long terme, en passant par le dépannage et l’optimisation. Sans cette couche, un superordinateur reste souvent en deçà de son potentiel ou, pire encore, n’atteint jamais ses objectifs de production.
Des utilisateurs qui évoluent plus vite que l’infrastructure
De plus, le profil type de l’utilisateur HPC a fondamentalement changé. Alors qu’autrefois les superordinateurs étaient principalement utilisés par des experts en ligne de commande et des scientifiques, ce sont désormais des équipes d’IA habituées à la simplicité du cloud qui s’en servent.
« L’utilisateur d’aujourd’hui voit un nouvel outil d’IA sur GitHub et veut le mettre en production la semaine suivante », explique Davidson. « Cette attitude fait que les superordinateurs modernes sont rarement homogènes. Ils exécutent un mélange de charges de travail HPC traditionnelles, d’entraînement d’IA, de tâches d’inférence, d’analyse de données et de frameworks expérimentaux. »
« De nouveaux modèles, bibliothèques et environnements d’exécution arrivent à un rythme effréné. L’infrastructure doit pouvoir y répondre en permanence, alors que le cycle de vie d’un tel système se mesure normalement en années. »
Cela exige de la flexibilité à tous les niveaux : du choix des CPU et GPU à la structure de la pile logicielle, jusqu’à la manière dont les plateformes de conteneurs et les outils open source sont intégrés. Le HPC n’est plus un exercice d’intégration ponctuel, mais un compromis en constante évolution entre performance, stabilité et innovation.
La loi de l’énergie et de la chaleur
Comme si cela ne suffisait pas, le secteur se heurte simultanément aux limites de la physique. Les besoins énergétiques des CPU modernes, et surtout des GPU, ont explosé ces dernières années. Alors que quelques centaines de watts par nœud suffisaient autrefois, nous sommes aujourd’hui bien au-delà.
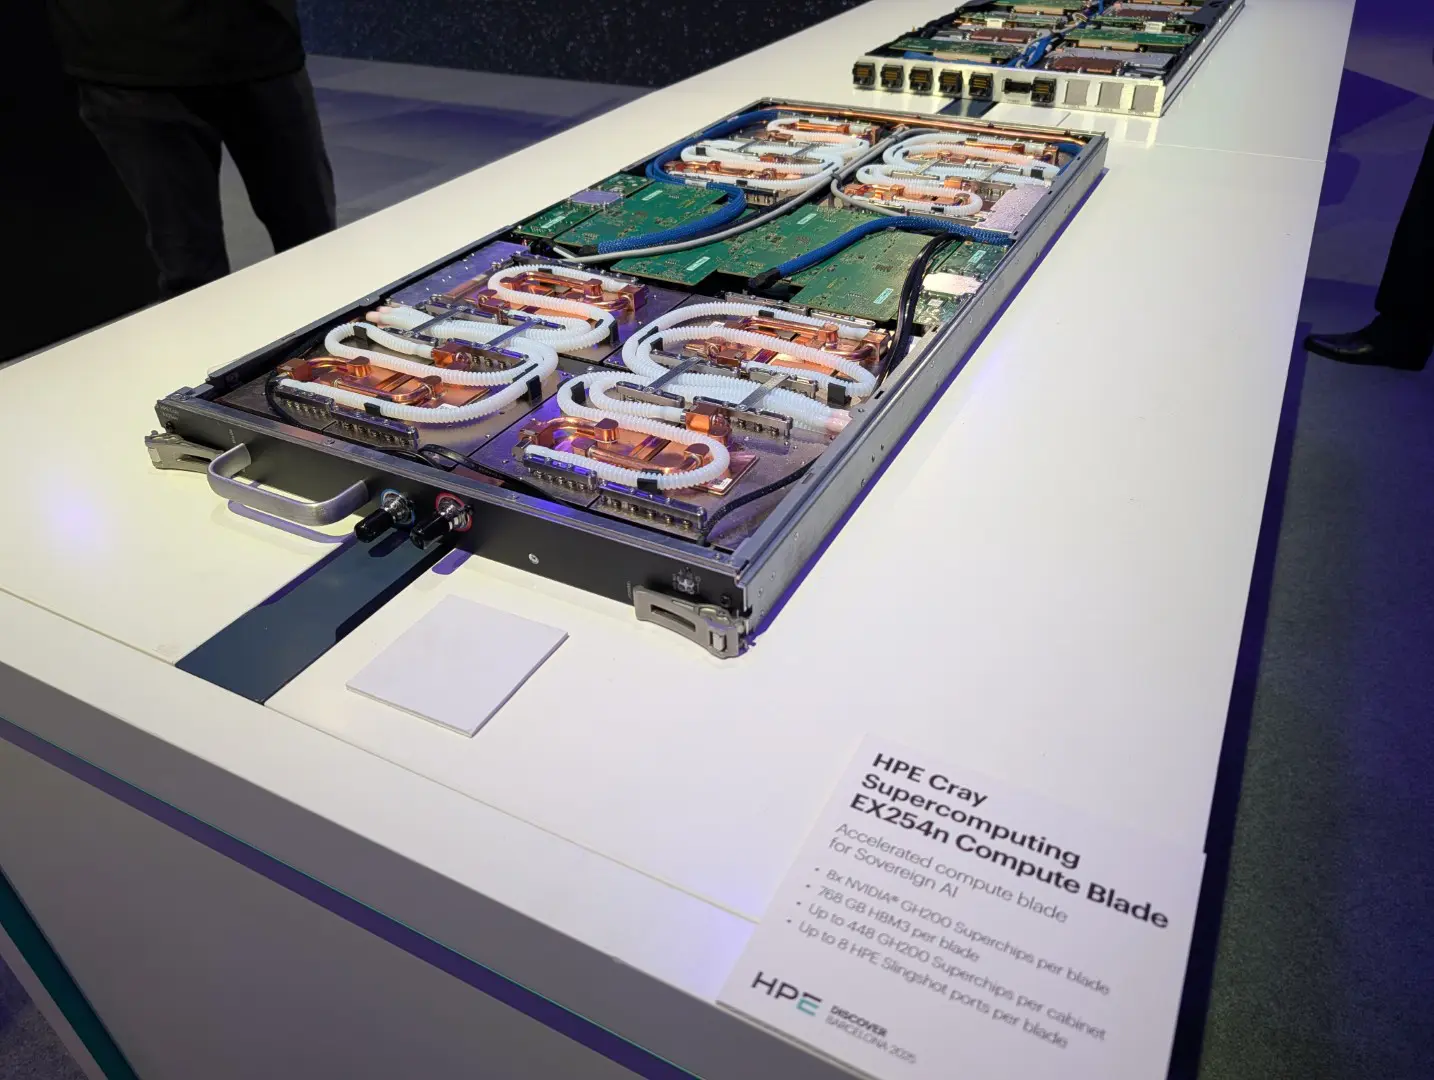
Davidson ne mâche pas ses mots : « Les CPU et GPU exigent désormais beaucoup plus de puissance qu’il y a cinq ans, ce qui entraîne plus de chaleur et plus de stress sur les composants. Cela a un impact direct sur les taux de défaillance et la disponibilité. Nous ne refroidissons pas seulement les CPU ou les GPU, mais le système complet — des barres omnibus aux commutateurs. »
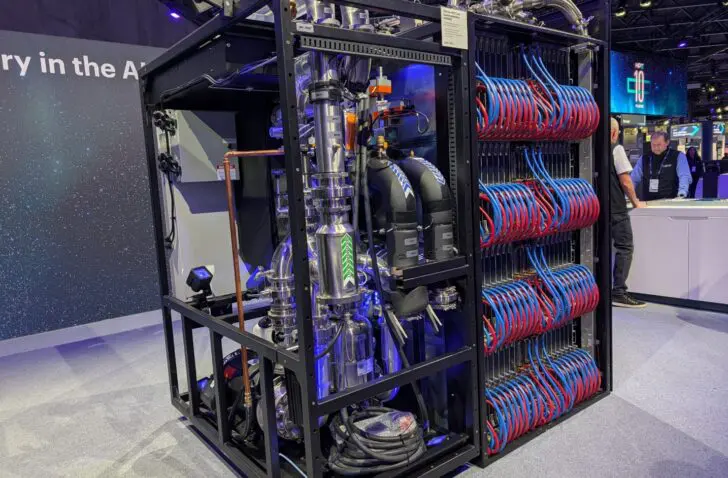
L’introduction de nouvelles solutions, comme une pompe « sidecar » permettant un refroidissement liquide plus efficace sans arrêter le système, illustre comment le refroidissement est devenu un élément stratégique de la conception. Il ne s’agit pas d’une optimisation de détail, mais d’une condition essentielle pour pouvoir exploiter des superordinateurs de manière fiable.
Trajectoires longues, délais raccourcis
Traditionnellement, les grands systèmes HPC étaient élaborés sur de longues périodes. Entre le concept initial et la livraison effective, plusieurs années s’écoulent souvent. Durant ce temps, l’architecture de base des CPU et des interconnexions changeait relativement peu.
Aujourd’hui, la situation est différente. L’IA et l’innovation des GPU ont considérablement accéléré la cadence. Les directions attendent des résultats plus rapides, tandis que les fabricants de puces lancent plus régulièrement de nouvelles générations. Davidson : « Les systèmes sont conçus sur le long terme, mais le cycle de travail se raccourcit. Pendant le processus, les feuilles de route des semi-conducteurs et les charges de travail changent, et il faut constamment s’ajuster. »
Réussir ne signifie pas avoir un plan parfait, mais posséder la capacité de corriger intelligemment le tir en cours de route.
Chris Davidson, responsable HPC et IA chez HPE
C’est pourquoi HPE travaille avec des équipes mixtes composées du client, d’experts HPE et de partenaires qui peaufinent ensemble l’architecture tout au long du projet. Le design initial n’est pas un point final, mais un point de départ qui est ajusté en permanence à mesure que les charges de travail, les puces et l’exploitation se précisent.
« Réussir ne signifie pas avoir un plan parfait, mais posséder la capacité de corriger intelligemment le tir en cours de route. »
Le vrai défi : l’exploitation, pas la construction
Pourtant, selon Davidson, la plus grande difficulté n’est pas la phase de construction, mais ce qui suit. « Installer le système est une chose, le maintenir opérationnel en est une autre. En pratique, il s’agit de surveillance, de détection proactive des problèmes, de gestion des micrologiciels et des pilotes, de planification des capacités, de l’intégration de nouveaux utilisateurs et charges de travail, et d’une gestion rapide des incidents. »
« Ici, le facteur humain réapparaît de manière flagrante. Nous investissons massivement dans les services, l’observabilité et même nos propres outils d’IA pour soutenir nos équipes de déploiement et de service dans la détection et la résolution des problèmes. »
Davidson souligne que la pénurie d’expertise est l’un des principaux facteurs de risque. Construire, déployer et gérer des systèmes aussi complexes requiert des profils spécialisés : architectes de solutions, ingénieurs de performance, équipes de service comprenant à la fois le matériel, le logiciel et les charges de travail. Sans ces personnes, même l’infrastructure la mieux conçue finit par s’enliser tôt ou tard.
Conformité et souveraineté numérique comme couche supplémentaire
Comme si la technologie, l’énergie et les compétences ne représentaient pas assez de défis, une solide couche de réglementation s’y ajoute en Europe. Le RGPD, NIS2, les normes ISO et les exigences nationales en matière de souveraineté numérique déterminent comment et où les plateformes HPC et d’IA peuvent fonctionner. Dans certains cas, il s’agit même d’environnements totalement isolés (« air-gapped ») où aucune connexion avec le monde extérieur n’est autorisée.
« Ce n’est pas seulement le calcul qui doit être souverain, mais aussi les données, les métadonnées, la gestion des clés et les opérations », affirme Davidson.
« Les superordinateurs ne sont donc plus de simples projets techniques, mais aussi des instruments stratégiques pour l’autonomie numérique des pays et des organisations. Les choix d’architecture ne sont pas seulement dictés par la performance et les coûts, mais aussi par des critères juridiques, géopolitiques et de sécurité. »
Conclusion
Construire des superordinateurs n’a jamais été simple, mais en 2025, c’est devenu une discipline à part entière. Davidson : « Le HPC n’est plus une couche technologique isolée ; c’est un écosystème où le matériel, le logiciel, l’humain, l’énergie et la réglementation s’influencent mutuellement en permanence. »
Quiconque souhaite aujourd’hui déployer une plateforme HPC ou d’IA qui reste pertinente pendant plusieurs années doit surtout retenir une leçon du récit de Davidson : le succès ne réside pas dans les unités de calcul elles-mêmes, mais dans la cohérence entre elles — et dans les personnes qui conçoivent, déploient et maintiennent le tout. Ce n’est qu’en comprenant cela que l’on construit non pas un superordinateur sur papier, mais un superordinateur qui continue de performer dans la pratique.