

OpenAI déploie des filigranes textuels dans l’Union européenne pour se conformer à l’EU AI Act. Le déploiement commence pour les abonnements ChatGPT et Codex éligibles dans l’Union européenne.
Depuis l’entrée en vigueur des nouvelles règles de transparence de l’AI Act le 2 août, les fournisseurs d’IA générative sont tenus de marquer les contenus générés par IA comme tels et de les rendre lisibles par machine. OpenAI commence avec des filigranes invisibles sur les textes générés par ChatGPT et Codex dans l’Union européenne pour se conformer à l’EU AI Act.
« À partir d’aujourd’hui, les clients API du monde entier peuvent opter pour des filigranes textuels pour certains modèles. Le filigrane textuel reste désactivé par défaut dans l’API », a déclaré OpenAI dans un article de blog. Les filigranes seront déployés au cours des prochaines semaines pour les utilisateurs ChatGPT et Codex éligibles sur tous les abonnements dans l’UE.
Filigranes TextGrain
La technologie de filigranage d’OpenAI, textGrain, ajoute un signal statistique invisible dans le choix des mots du modèle. Le détecteur analyse les passages à la recherche de ce signal pour déterminer si un filigrane OpenAI est présent. Selon le rapport technique d’OpenAI, textGrain est au moins aussi performant que d’autres méthodes testées comme SynthID pour le texte.
Dans des conditions idéales, l’outil détecte une grande partie du texte marqué par filigrane, mais OpenAI souligne que cela peut être moins fiable en utilisation quotidienne. La technologie sera à terme disponible en open source afin que d’autres parties puissent l’examiner et s’en inspirer. Pour les organisations, cela doit rendre plus transparents les morceaux de texte influencés par les modèles d’OpenAI.
La modification affaiblit le filigrane
Le taux de détection dépend fortement de la longueur et du type de texte. Avec un taux de faux positifs souhaité de 1 %, le détecteur a reconnu environ 80 % des passages marqués par filigrane de 200 tokens et environ 95 % pour 400 tokens dans du contenu de psychologie. Pour les textes présentant peu de variations dans le choix des mots, comme les mathématiques, les taux de détection sont nettement inférieurs.
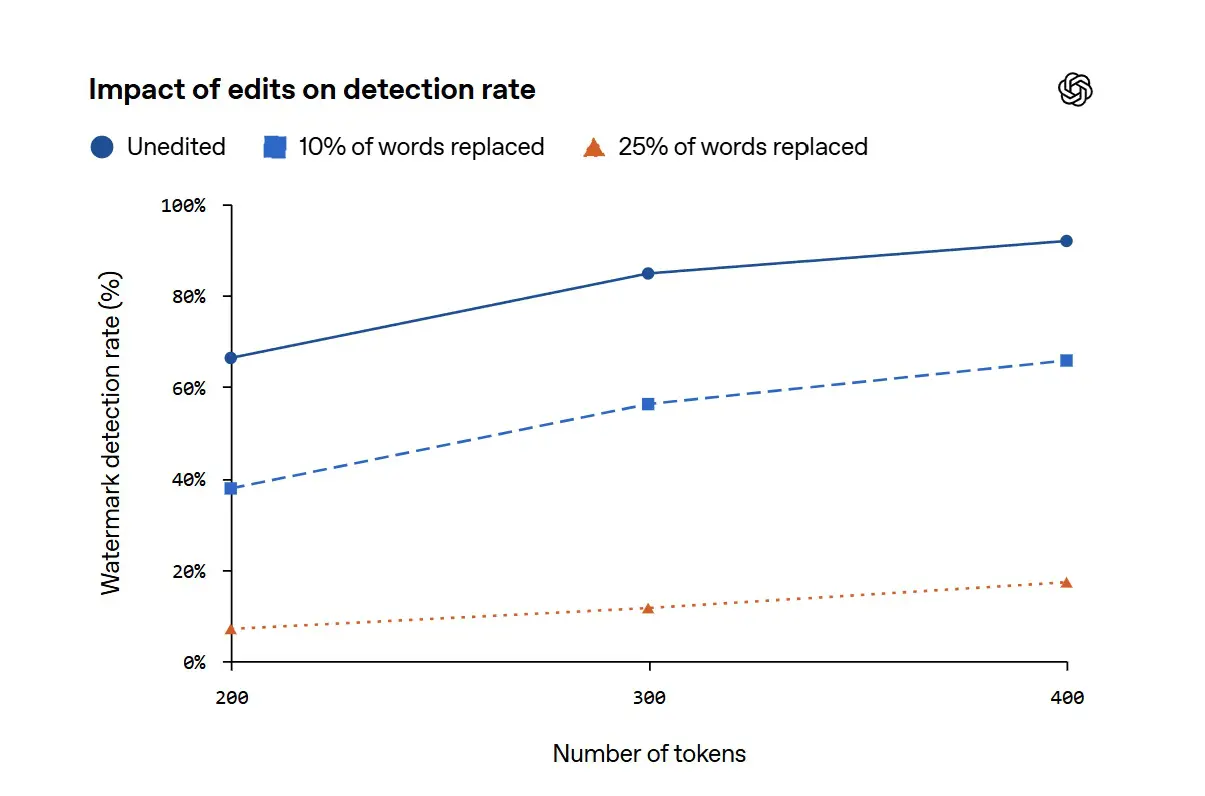
La modification du texte affaiblit rapidement le filigrane. Dans des passages de 400 tokens, la détection est passée d’environ 92 à 66 % lorsque 10 % des mots étaient remplacés par des synonymes. Avec 25 % de remplacement, ce chiffre est tombé à 17 %. « Ces limitations contribuent à notre décision de n’offrir le premier accès au détecteur qu’à des chercheurs approuvés et à des organisations expertes, qui peuvent nous aider à évaluer la fiabilité et l’utilisation responsable », a déclaré l’entreprise.
Aucune preuve d’« auteur humain »
En outre, OpenAI avertit qu’un filigrane manquant « ne prouve pas une paternité humaine ». « Les filigranes peuvent indiquer qu’un système OpenAI a généré ou traité une partie d’un passage, mais pas la part de jugement humain, de modification ou de créativité qui y a été investie », selon l’entreprise.
Les nouvelles règles de transparence lancent un mouvement plus large pour les fournisseurs d’IA. Outre OpenAI, Anthropic, Google et Microsoft, entre autres, ont donné leur accord sur l’obligation d’étiquetage dans l’UE. En août, Anthropic a commencé à apposer des filigranes sur les textes et images générés par IA, tout comme Microsoft dans Copilot et Google dans Gemini.