

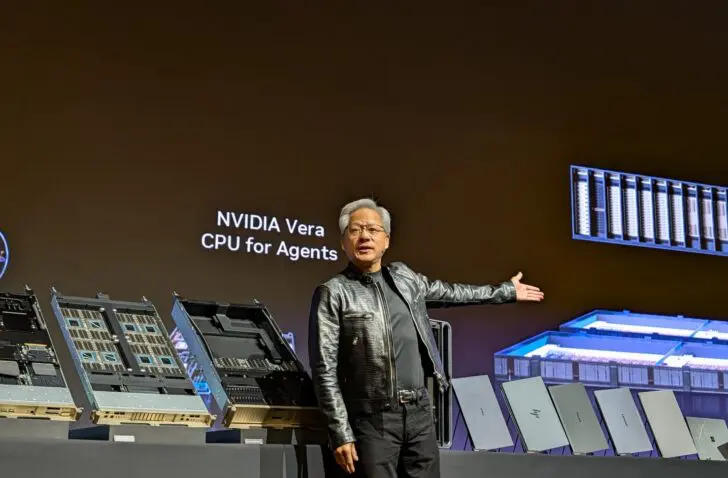
L’un des meilleurs moyens d’améliorer l’utilisation de la mémoire est de travailler avec une précision extrêmement basse. Cela semble négatif, mais ce n’est pas forcément le cas selon le PDG de Nvidia.
Lors d’un point presse au Computex, le PDG de Nvidia, Jensen Huang, explique comment le fabricant de puces entend contrer la pénurie mondiale de mémoire. Il souhaite faire plus avec moins afin de réduire considérablement l’utilisation de la mémoire.
« La clé est le NVFP4, un format 4 bits qui double le nombre de paramètres dans le même espace mémoire, complété par des techniques d’IA telles que le rendu neuronal et la compression de textures neuronales. »
Ordinateur RTX Spark
« L’un des meilleurs moyens d’améliorer l’utilisation de la mémoire est de travailler avec une précision extrêmement basse », explique-t-il. « Au lieu de stocker des valeurs en 8 ou 16 bits, nous les compressons en quatre bits. De cette manière, un même modèle tient dans la moitié ou le quart de l’espace. »
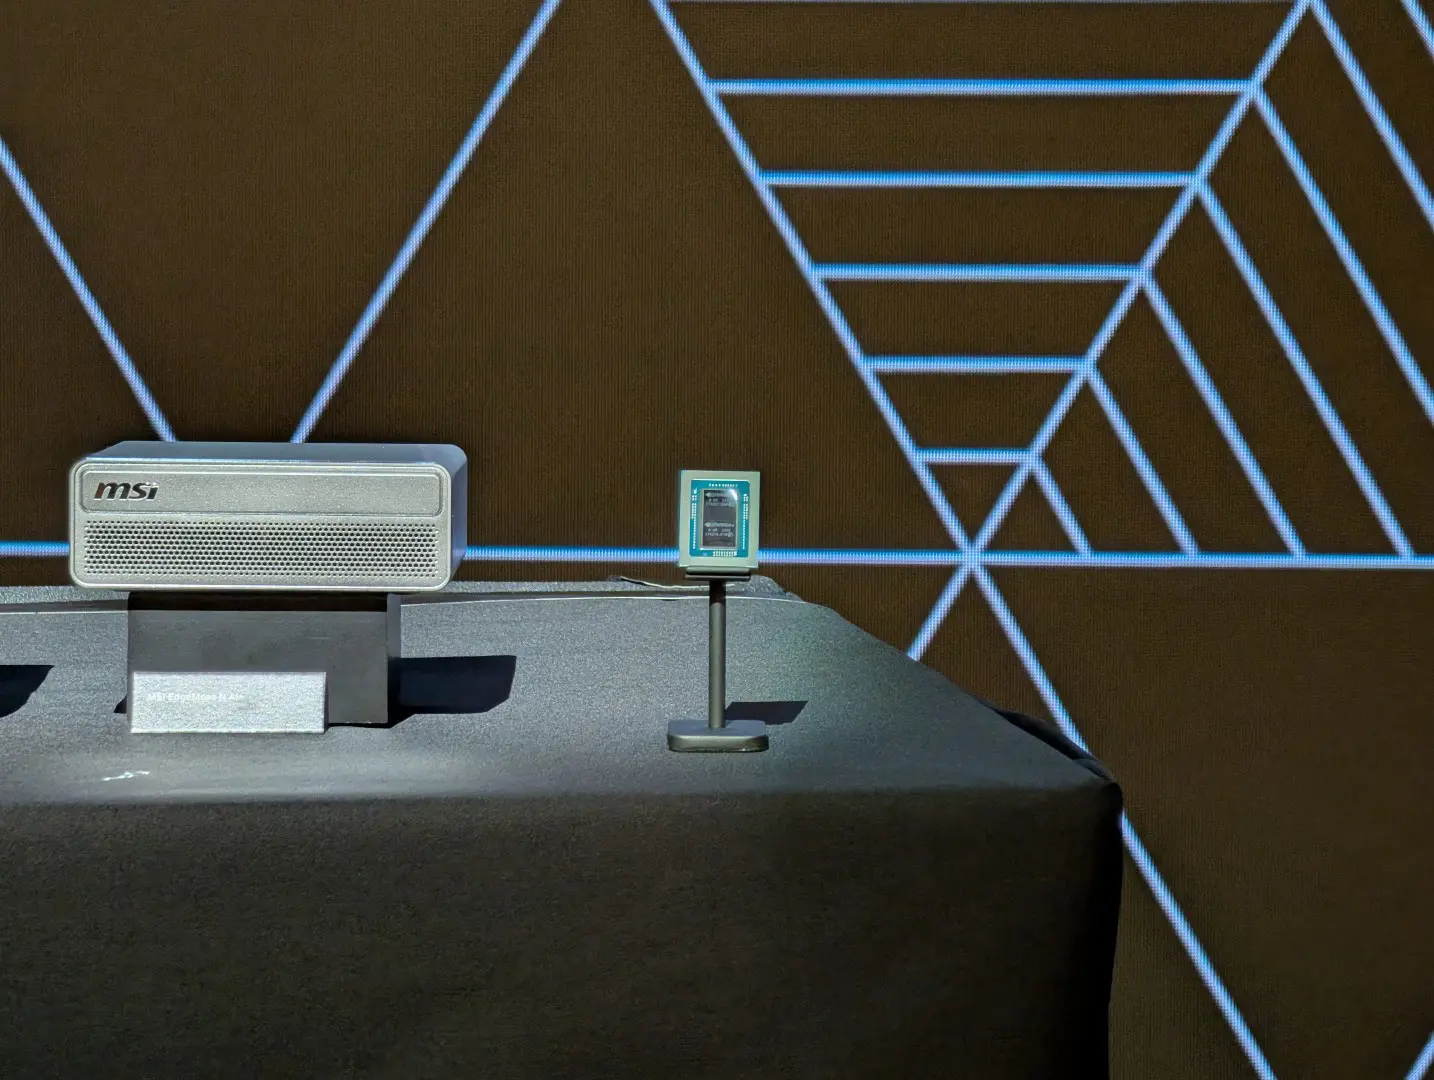
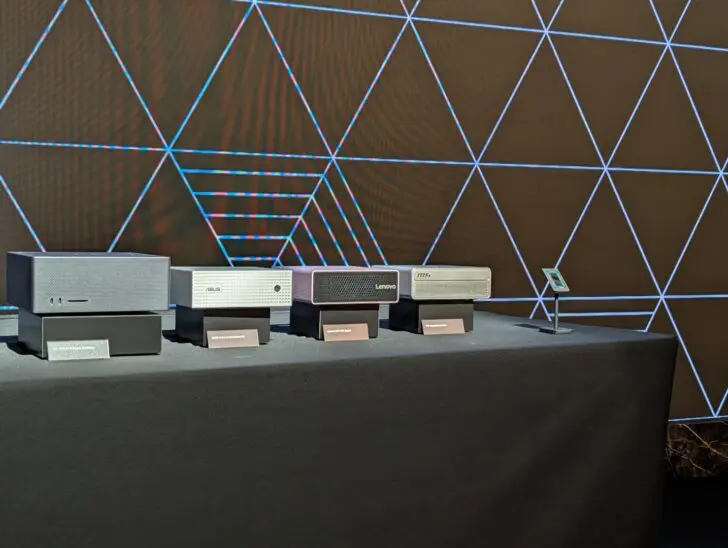
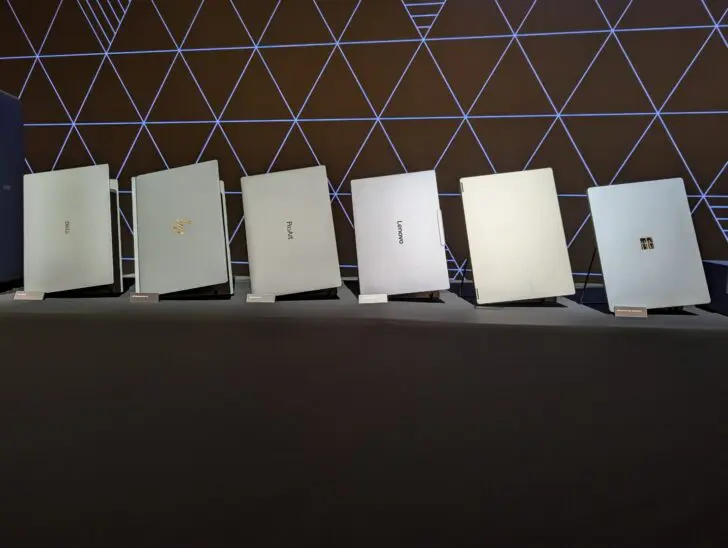
Cette philosophie n’est pas nouvelle, mais Nvidia l’étend désormais aux PC grand public et professionnels. RTX Spark, la puce Windows que Nvidia a conçue en collaboration avec MediaTek, s’appuie fortement sur la réduction de précision via les Tensor Cores pour permettre l’exécution d’agents d’IA locaux sans saturer la mémoire.
Ce qui différencie le NVFP4
Le NVFP4 est le format à virgule flottante 4 bits propre à Nvidia, introduit avec l’architecture Blackwell. Chaque nombre est stocké dans la structure E2M1 : un bit de signe, deux bits d’exposant et un bit de mantisse. Par conséquent, une valeur unique ne peut prendre qu’une poignée de niveaux. Pensez à la série 0, 0,5, 1, 1,5, 2, 3, 4 et 6, tant positifs que négatifs, dans une plage d’environ -6 à 6.
En soi, c’est bien trop imprécis pour les réseaux neuronaux. Nvidia résout ce problème avec un système de facteurs d’échelle à deux niveaux. Pour chaque micro-bloc de seize valeurs, un facteur d’échelle FP8 (E4M3) précis est appliqué, auquel s’ajoute un facteur d’échelle FP32 global pour l’ensemble du tenseur.
Concurrence avec le MXFP4
C’est précisément cette taille de bloc réduite qui fait la différence avec le format concurrent MXFP4, lequel utilise des blocs de 32 valeurs : en divisant par deux pour passer à seize valeurs, le NVFP4 obtient deux fois plus de points de référence et limite l’erreur de quantification.
« Le NVFP4 n’est pas seulement de la virgule flottante 4 bits, c’est une structure tensorielle complète, une structure mathématique entière capable de calculer avec une précision de seulement quatre bits, mais qui bascule dynamiquement entre 4, 8, 16 et même 32 bits si nécessaire », déclare Huang. Il souligne toutefois que le format 4 bits est utilisé autant que possible.
« La cinquième génération de Tensor Cores de Blackwell traite ce format au niveau matériel, y compris le regroupement des éléments et la mise à l’échelle dynamique. » Selon Nvidia, cela permet d’obtenir un débit jusqu’à six fois plus élevé et de diviser par deux l’utilisation de la mémoire par rapport au FP8, tout en conservant une précision proche de celle du FP16.
Mémoire rare
Huang a résumé le gain concret pour RTX Spark en un seul chiffre : « Cela nous permet de compresser le réseau neuronal que nous plaçons en mémoire, et ainsi de doubler le nombre de paramètres dans seulement 128 gigaoctets. » En d’autres termes, un modèle qui ne tiendrait normalement pas localement peut désormais s’exécuter sur l’appareil lui-même.
Ce n’est pas un détail, mais le cœur de la stratégie de Nvidia. Les agents d’IA locaux nécessitent de nombreux paramètres pour être utiles, et la mémoire est précisément le composant rare et coûteux. En divisant par deux l’empreinte mémoire, Nvidia rend les agents d’IA réalisables sur un PC plutôt qu’exclusivement dans le centre de données. Ce timing n’est pas fortuit alors que les prix de la mémoire sont sous pression à l’échelle mondiale.
Alors que le marché se concentre principalement sur la disponibilité des capacités HBM et DRAM, Nvidia choisit délibérément de résoudre le problème en partie par le logiciel et les formats. Le NVFP4 déplace la charge de « l’achat de plus de mémoire » vers une « gestion plus intelligente de la mémoire ». Pour une plateforme comme RTX Spark, qui promet des agents d’IA locaux toujours actifs, c’est peut-être l’atout décisif.