

Avec le Ryzen AI Halo, AMD commercialise pour la première fois un PC complet sous son propre nom. Ce n’est pas le matériel, mais la pile logicielle organisée autour de ROCm qui constitue l’atout majeur. La question est : pour qui AMD commercialise-t-il le Ryzen AI Halo ?
Au Computex, presque tout tourne cette année autour de ce que l’on appelle l’Agent Computer : un PC qui comprend les prompts, planifie des actions et exécute des tâches de manière largement autonome. AMD prend le train en marche avec le Ryzen AI Halo, un mini-PC que l’entreprise a annoncé au CES début 2026 et qui sera disponible en rayon dès l’été.
Cette fois, AMD ne vend pas une puce (AMD Ryzen AI Max+, mieux connue sous le nom d’AMD Strix Halo) à un fabricant pour construire l’ordinateur, mais le construit lui-même. Pourquoi un fondeur assemble-t-il soudainement une machine complète ? Nous avons posé la question à Rakesh Anigundi, responsable produit pour Ryzen AI chez AMD.
Pourquoi AMD construit un PC
La réponse revient à la vitesse, selon Anigundi. « Nous voulions faire la meilleure première impression possible. Si nous ne fabriquions que le matériel et devions compter sur un partenaire externe pour offrir la bonne expérience dès le départ, ce n’aurait pas été le bon choix en termes d’agilité. »
Cette agilité n’est pas un détail. AMD publie une nouvelle version de ROCm toutes les six semaines et souhaite mettre à jour le logiciel de la box Halo mensuellement. « Il est très difficile de maintenir ce rythme lorsqu’un tiers est impliqué », explique Anigundi.
La stratégie est donc délibérément progressive : AMD construit tout lui-même, lance le produit, établit un rythme et ne fait appel à des partenaires pour passer à l’échelle mondiale qu’ensuite. « HP et Lenovo sont déjà prêts à suivre, d’autres OEM rejoindront le mouvement plus tard », précise Anigundi.
D’autres fabricants expérimentent d’ailleurs déjà depuis un certain temps des mini-PC basés sur le même Strix Halo, comme Acer et HP. Ce qui distingue le mini-PC AMD Ryzen AI Halo de ces appareils n’est pas la puce, selon Anigundi. « L’ingrédient secret ici est la pile logicielle. La magie réside purement dans le logiciel. »
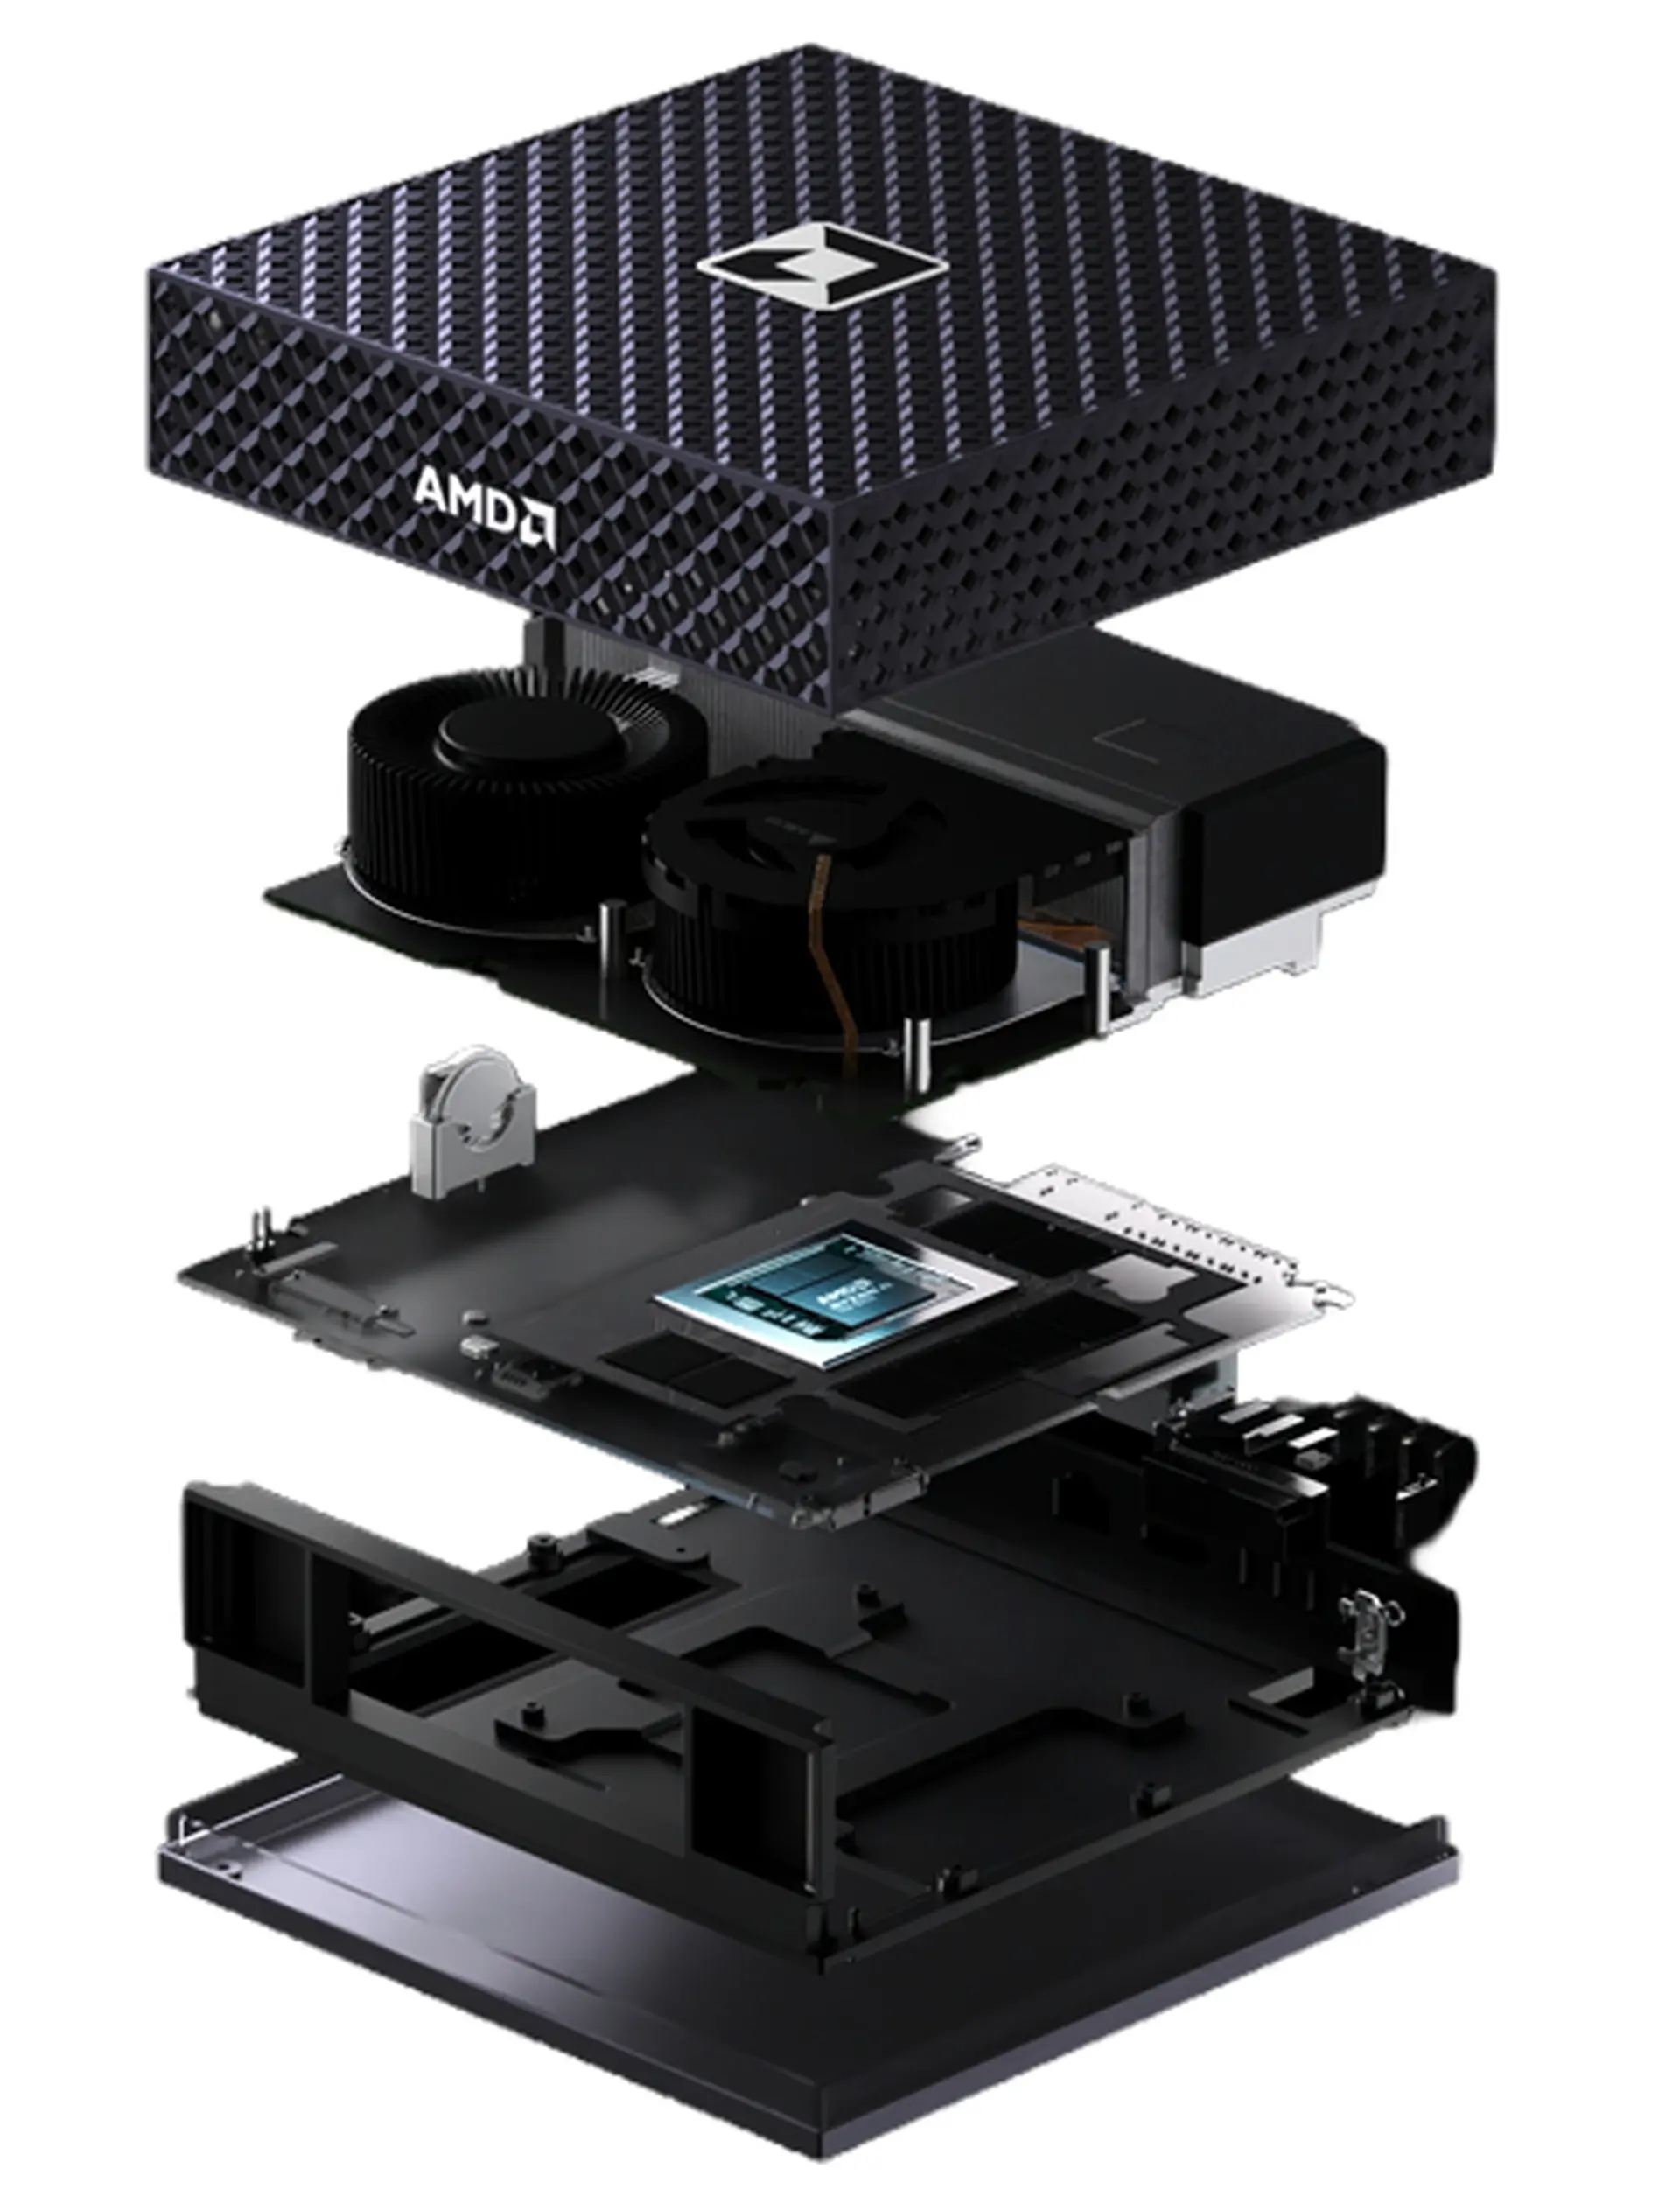
Le logiciel est la véritable star
Cela ressemble à du marketing, mais il y a une philosophie concrète derrière. Le mantra de conception du PC est : « de la pression sur le bouton à un modèle de langage opérationnel, en quelques minutes ». Quiconque allume le Halo voit apparaître un Developer Center qui affiche toutes les applications préinstallées – ComfyUI, LM Studio, le propre Lemonade d’AMD et plus encore. Un seul clic suffit pour tout mettre à jour.
Plus important encore est ce qui se trouve en dessous : la bonne version de ROCm, les pilotes, PyTorch et les dépendances Python ont déjà été triés pour vous. ROCm, la réponse d’AMD au CUDA de Nvidia, est historiquement l’élément pour lequel les développeurs manifestent un enthousiasme limité, car la part de marché de Nvidia et la pile logicielle associée sont bien plus importantes.
Playbooks et Lemonade
AMD y ajoute des Playbooks : une dizaine de recettes validées par AMD pour les applications les plus importantes, de l’inférence LLM à la génération d’images en passant par le fine-tuning. Et si quelqu’un casse le système, il suffit d’appuyer sur un bouton pour revenir à une « meilleure configuration connue ».
Lemonade est notre arme secrète. C’est un serveur que vous installez en un clic et qui peut faire tourner n’importe quel modèle de langage local derrière une API compatible OpenAI
Rakesh Anigundi, responsable produit pour Ryzen AI chez AMD
L’étape suivante, selon Anigundi, est l’automatisation via des compétences (skills). « Nous jouons avec l’idée de skills, où un agent peut lire toutes ces instructions validées, afin que vous et moi puissions simplement dire : installe sur cette box AMD la recette de fine-tuning. »
Le logiciel qu’Anigundi cite le plus souvent est Lemonade. « Lemonade est en fait notre arme secrète », s’amuse-t-il. C’est un serveur que vous installez en un clic et qui peut faire tourner n’importe quel modèle de langage local derrière une API compatible OpenAI. « Vous n’avez pas besoin d’adapter votre API OpenAI. Au lieu d’un modèle cloud, vous laissez simplement la même application s’adresser à un modèle local. »
Une nouvelle définition du « développeur »
À qui tout cela est-il destiné ? C’est là que ça devient intéressant, car AMD redéfinit la notion de développeur. « Notre conception de qui est un développeur a radicalement changé en six mois », déclare Anigundi. « De toute ma vie, je n’avais jamais soumis de pull request sur GitHub. Maintenant, il y en a dix à mon nom, simplement parce qu’il est devenu si facile de coder avec son agent. »
Le groupe cible primaire n’est donc pas seulement le programmeur chevronné, mais tout autant le créateur émergent qui souhaite faire tourner des agents d’IA sans avoir toutes les connaissances techniques. En même temps, il s’avère que ce sont justement ces professionnels du logiciel expérimentés qui apprécient la préparation : ils veulent consacrer du temps au code, pas au débogage de ROCm, PyTorch et des dépendances Python.
Pourquoi autant de mémoire ?
Le Halo fonctionne sur Strix Halo avec 128 Go de mémoire unifiée, dont une grande partie peut servir de VRAM. L’amélioration la plus demandée par les développeurs est plus de VRAM, et elle arrivera avec le successeur Gorgon Halo au troisième trimestre : jusqu’à 192 Go de mémoire unifiée et jusqu’à 160 Go de VRAM. Mais pourquoi autant de mémoire sur un appareil dont le GPU n’est pas précisément le plus puissant ?
Anigundi souligne trois changements. Premièrement, l’architecture mixture of experts : un modèle de 200 à 300 milliards de paramètres se compose d’experts plus petits dont seule une fraction est active par question. Il faut cependant pouvoir charger l’intégralité du modèle en mémoire, sinon on perd tout en latence entre la RAM et le SSD. « Presque tous les modèles de pointe, y compris les modèles frontier des grands acteurs de l’IA, sont des mixture of experts. »
Deuxièmement, on souhaite conserver plusieurs agents d’IA simultanément en mémoire. Et troisièmement, le plus important : le contexte. « La véritable application phare pour plus de VRAM est la taille du contexte. Plus le contexte est grand, meilleure est la qualité de vos réponses. »
L’aspect financier rend les choses concrètes. Anigundi a d’abord fait tourner un agent de briefing sur Perplexity, ce qui représentait 50 à 100 crédits par rapport. « Cela me coûtait un à deux dollars à chaque fois. Maintenant, ce même agent tourne localement sur ma box avec un modèle Qwen d’environ 30 milliards de paramètres, et je suis très satisfait de la qualité. » Pour les agents qui tournent en continu, chaque token compte sur la facture cloud.
Tout le monde veut être identique
L’approche d’AMD semble convaincante, mais elle est presque identique à celle de la concurrence. Avec le DGX Spark, Nvidia vend déjà depuis un certain temps son propre PC pour les développeurs. Parallèlement, il a lancé au Computex le RTX Spark plus NemoClaw – une plateforme d’agents qui, oui, fonctionne avec des « playbooks » et une expérience de démarrage « en quelques minutes » et place les modèles locaux derrière une API compatible OpenAI.
Le vocabulaire est littéralement le même. Le véritable champ de bataille n’est donc pas le matériel, mais la maturité de la pile logicielle, et là, Nvidia a des années d’avance sur le ROCm d’AMD avec CUDA.
Microsoft apporte aussi sa contribution. Lors de la Build 2026, l’entreprise a présenté avec le Project Solara une vision d’un système d’exploitation pour agents, et avec le plan Aion 1.0, le raisonnement local sur des puces d’AMD, Intel, Qualcomm et Nvidia.
Anigundi voit cette couche comme complémentaire : « Le matériel reste le matériel, mais cela relie l’ensemble. » En ce qui nous concerne, c’est précisément là que réside le risque. Si Microsoft déplace la couche agent et le sandboxing, une question qu’Anigundi soulève lui-même, vers l’OS, la box physique risque de devenir une commodité sur laquelle la véritable bataille se jouera ailleurs.
Il est encore tôt
La promesse du boot to tokens in minutes dépend de la capacité de ces mises à jour mensuelles à continuer de dompter efficacement la prolifération des modèles et des frameworks. Quiconque utilise déjà lui-même un PC Strix Halo sait que ROCm se heurte encore souvent à des limites dans un monde où CUDA règne en maître.
Ce qu’AMD a en revanche entre les mains, c’est une deuxième voix crédible dans un marché qui ne fait que se former. Un deuxième acteur sérieux aux côtés de Nvidia est précisément ce dont le développement local de l’IA a besoin, et avec les 192 Go annoncés du Gorgon Halo, AMD pose sur la table un atout mémoire que les 128 Go de Nvidia n’égalent pas pour l’instant.
L’AMD Ryzen AI Halo sortira fin juin. « Nous ensemençons le marché avec notre propre PC AMD », résume Anigundi à propos de l’approche. « Avancer rapidement, préparer le terrain, créer une bonne combinaison matériel-logiciel, puis faire appel aux partenaires pour passer à une large échelle. » Les OEM prendront ensuite le relais de la distribution, tandis qu’AMD continuera de déterminer le rythme logiciel. Il reste à voir dans les mois à venir si la promesse logicielle aura autant de succès que le discours marketing.