

L’entreprise allemande ExpectedIT développe avec LPool une puce qui fusionne tous les processeurs, la mémoire, le stockage et les cartes réseau d’un rack de serveurs en un seul grand ordinateur, par analogie avec ce que le NVLink de Nvidia fait pour les GPU. Intel a déjà accordé une licence pour son protocole UPI, et Microsoft ainsi que Meta ont validé l’architecture, mais la puce elle-même n’existe pas encore. Une levée de fonds de 25 millions d’euros doit d’abord aboutir.
« Rien de fondamental n’a changé dans le serveur depuis des décennies », déclare Klas Moreau, CEO d’ExpectedIT. Le Suédois n’est pas un inconnu dans le monde des semi-conducteurs : il a développé des produits chez Ericsson pendant dix-sept ans, puis a dirigé pendant six ans le spécialiste suédois de la compression ZeroPoint Technologies.
Depuis avril, il est à la tête d’ExpectedIT, une start-up de Stuttgart comptant seize ingénieurs. Le cofondateur et CPO, le Dr Burkhard Steinmacher-Burow, a travaillé pendant 21 ans chez IBM sur l’architecture des superordinateurs Blue Gene, et c’est précisément là que se trouve l’origine de l’entreprise : pourquoi ne pas coupler les serveurs d’un centre de données comme nous le faisons pour les superordinateurs ?
Du goulot d’étranglement GPU au goulot d’étranglement CPU
Selon Moreau, le moment est venu de se poser cette question. À l’ère de ChatGPT, tout tourne autour des GPU : l’entraînement et l’inférence se font sur des accélérateurs, et Nvidia résout le problème d’échelle avec NVLink. Ce dernier est une interconnexion qui transforme un rack complet en un seul grand GPU. L’IA agentique change la donne. Les agents fonctionnent 24h/24 et 7j/7, appellent des outils et des API et orchestrent des tâches, et ce travail incombe au CPU. ExpectedIT table sur une puissance de calcul CPU dix fois supérieure à celle de l’ère générative classique.
Moreau met en avant quatre autorités pour appuyer ses propos. Lisa Su, PDG d’AMD, voit le marché des CPU pour serveurs doubler pour atteindre 120 milliards de dollars d’ici 2030 sur la base des commandes enregistrées ; UBS table même sur 170 milliards de dollars, tandis que Morgan Stanley a calculé que 50 à 90 % de la latence des charges de travail agentiques se situe du côté du CPU.
Même Nvidia construit désormais ses propres racks composés uniquement de CPU. Ce ne sont que des projections en pleine effervescence de l’IA, à prendre avec des pincettes, mais la direction est remarquablement unanime : le goulot d’étranglement se déplace du GPU vers l’hôte.
Le rack comme un seul ordinateur
Aujourd’hui, un serveur communique avec ses voisins via Ethernet. C’est rapide, mais terriblement lent par rapport à la vitesse à laquelle un CPU accède à sa propre mémoire. Quiconque exécute une charge de travail qui ne tient pas sur un seul serveur doit la diviser laborieusement. Il en résulte des ressources « échouées » : Microsoft Research a documenté que 30 à 40 % de la mémoire dans les environnements de production virtualisés reste inutilisée dans un serveur, alors que le serveur voisin manque de mémoire.
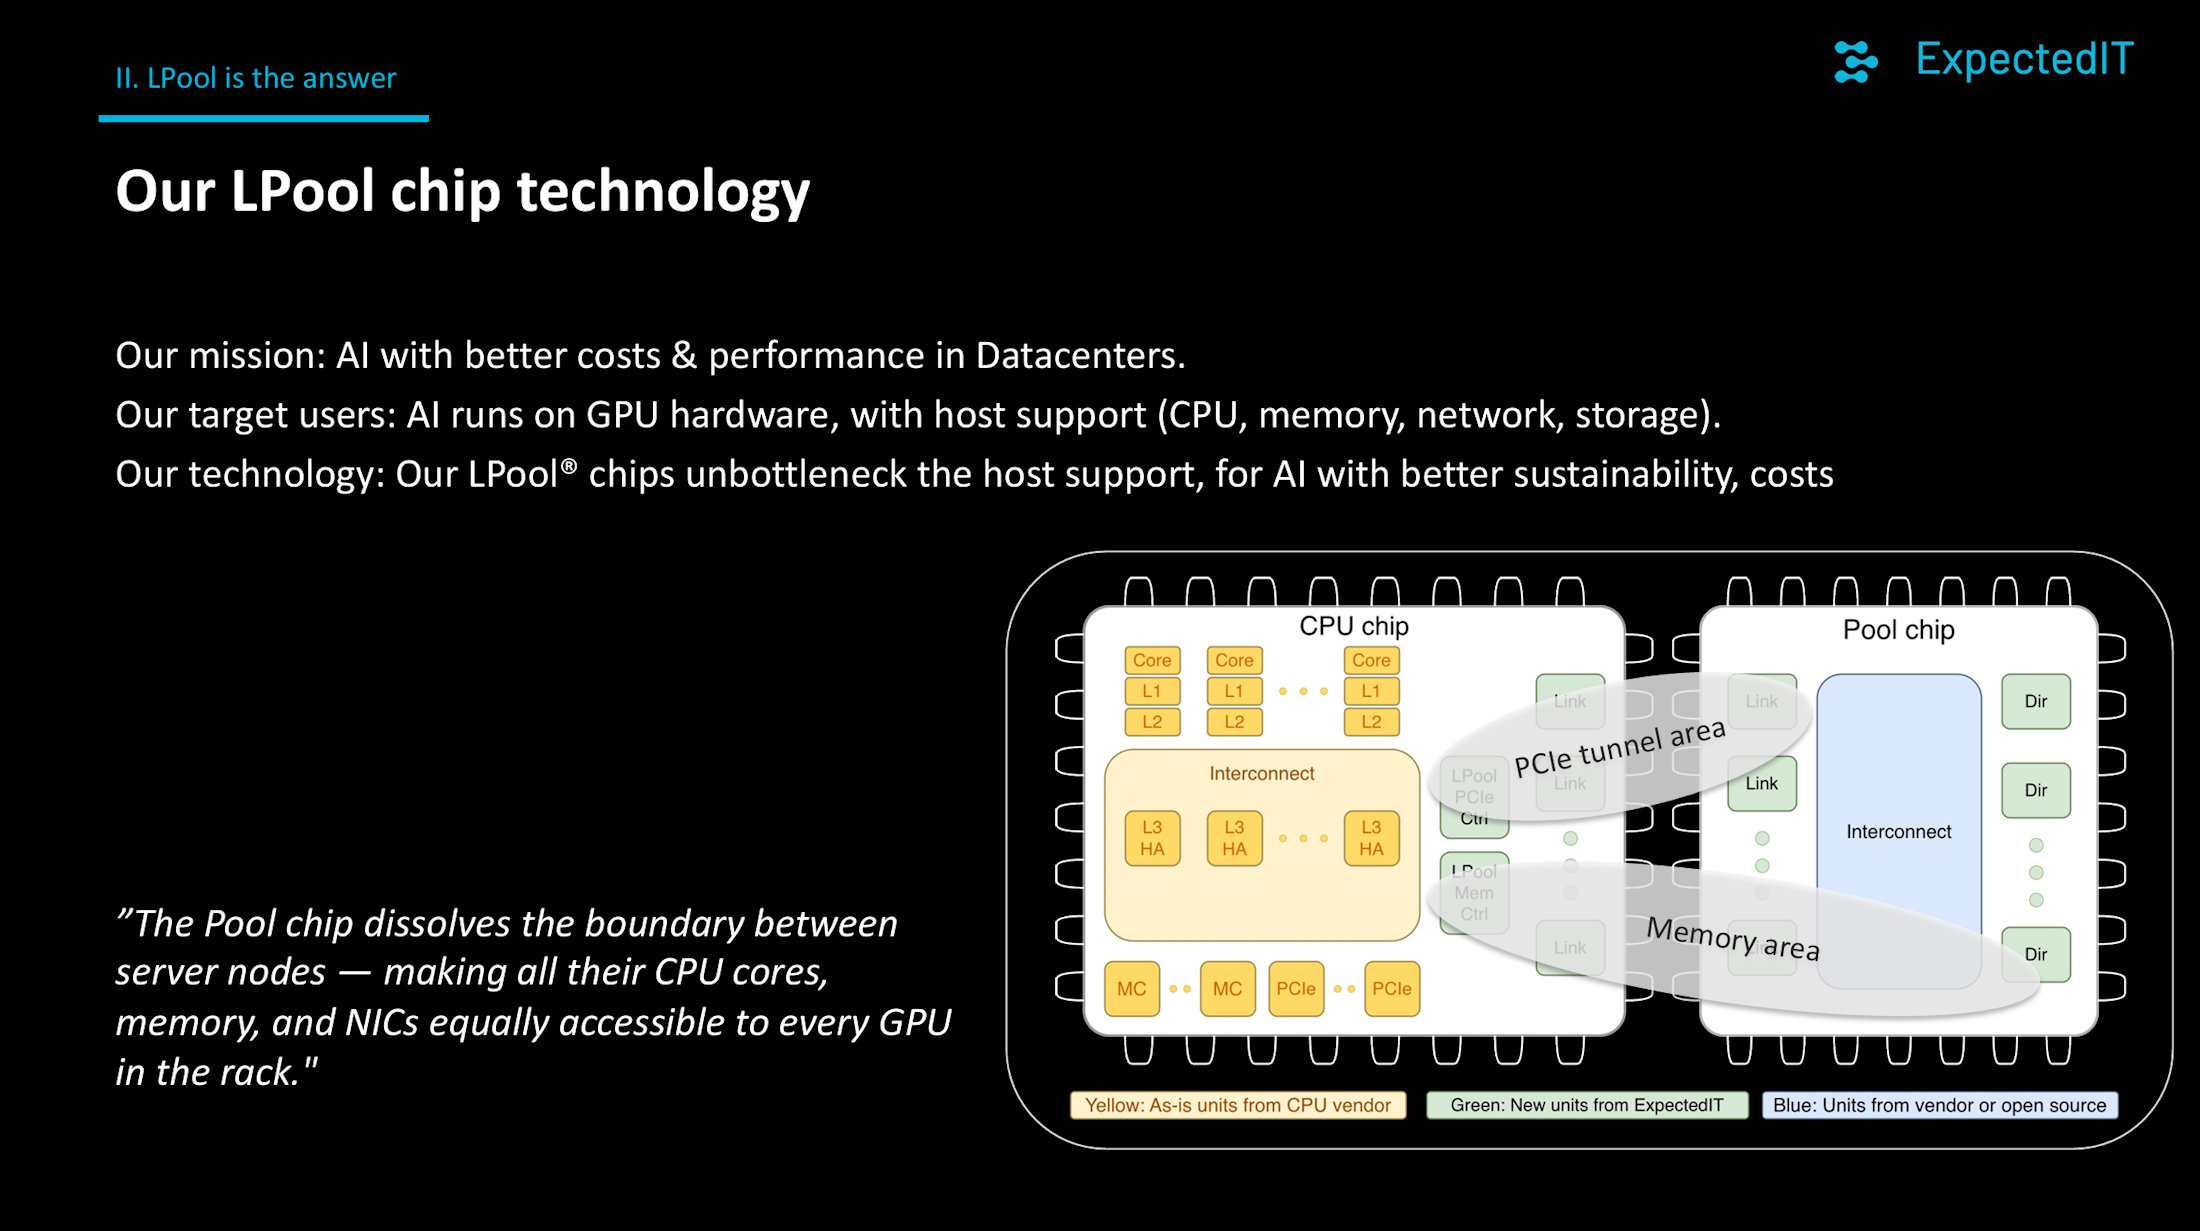
LPool, abréviation de Large Pool, doit résoudre ce problème. Une puce LPool d’ExpectedIT vient se placer à côté de chaque CPU : une fine couche logique au-dessus de l’interface PCIe existante qui efface les frontières entre les serveurs. Le rack se comporte alors comme une seule machine dans laquelle chaque processeur voit la mémoire, le stockage et les accélérateurs de l’ensemble du rack à une distance d’un seul bond (« hop »).
Le système d’exploitation ne remarque pas grand-chose : Linux prend déjà en charge les machines dotées de nombreux sockets. Celui qui a besoin de huit CPU et d’un téraoctet de mémoire les reçoit ; une fois terminé, tout est libéré pour la charge de travail suivante.
La promesse : jusqu’à 50 % de tokens IA en plus avec le même matériel, car les GPU n’attendent plus qu’un CPU leur fournisse des données. « Chaque seconde qu’un GPU passe à attendre des données est un manque à gagner », affirme Moreau. Ces 50 % ne sont pour l’instant qu’une affirmation théorique : une première démonstration avec des charges de travail IA ne suivra que fin septembre. Les puces n’existent pas encore pour le moment.
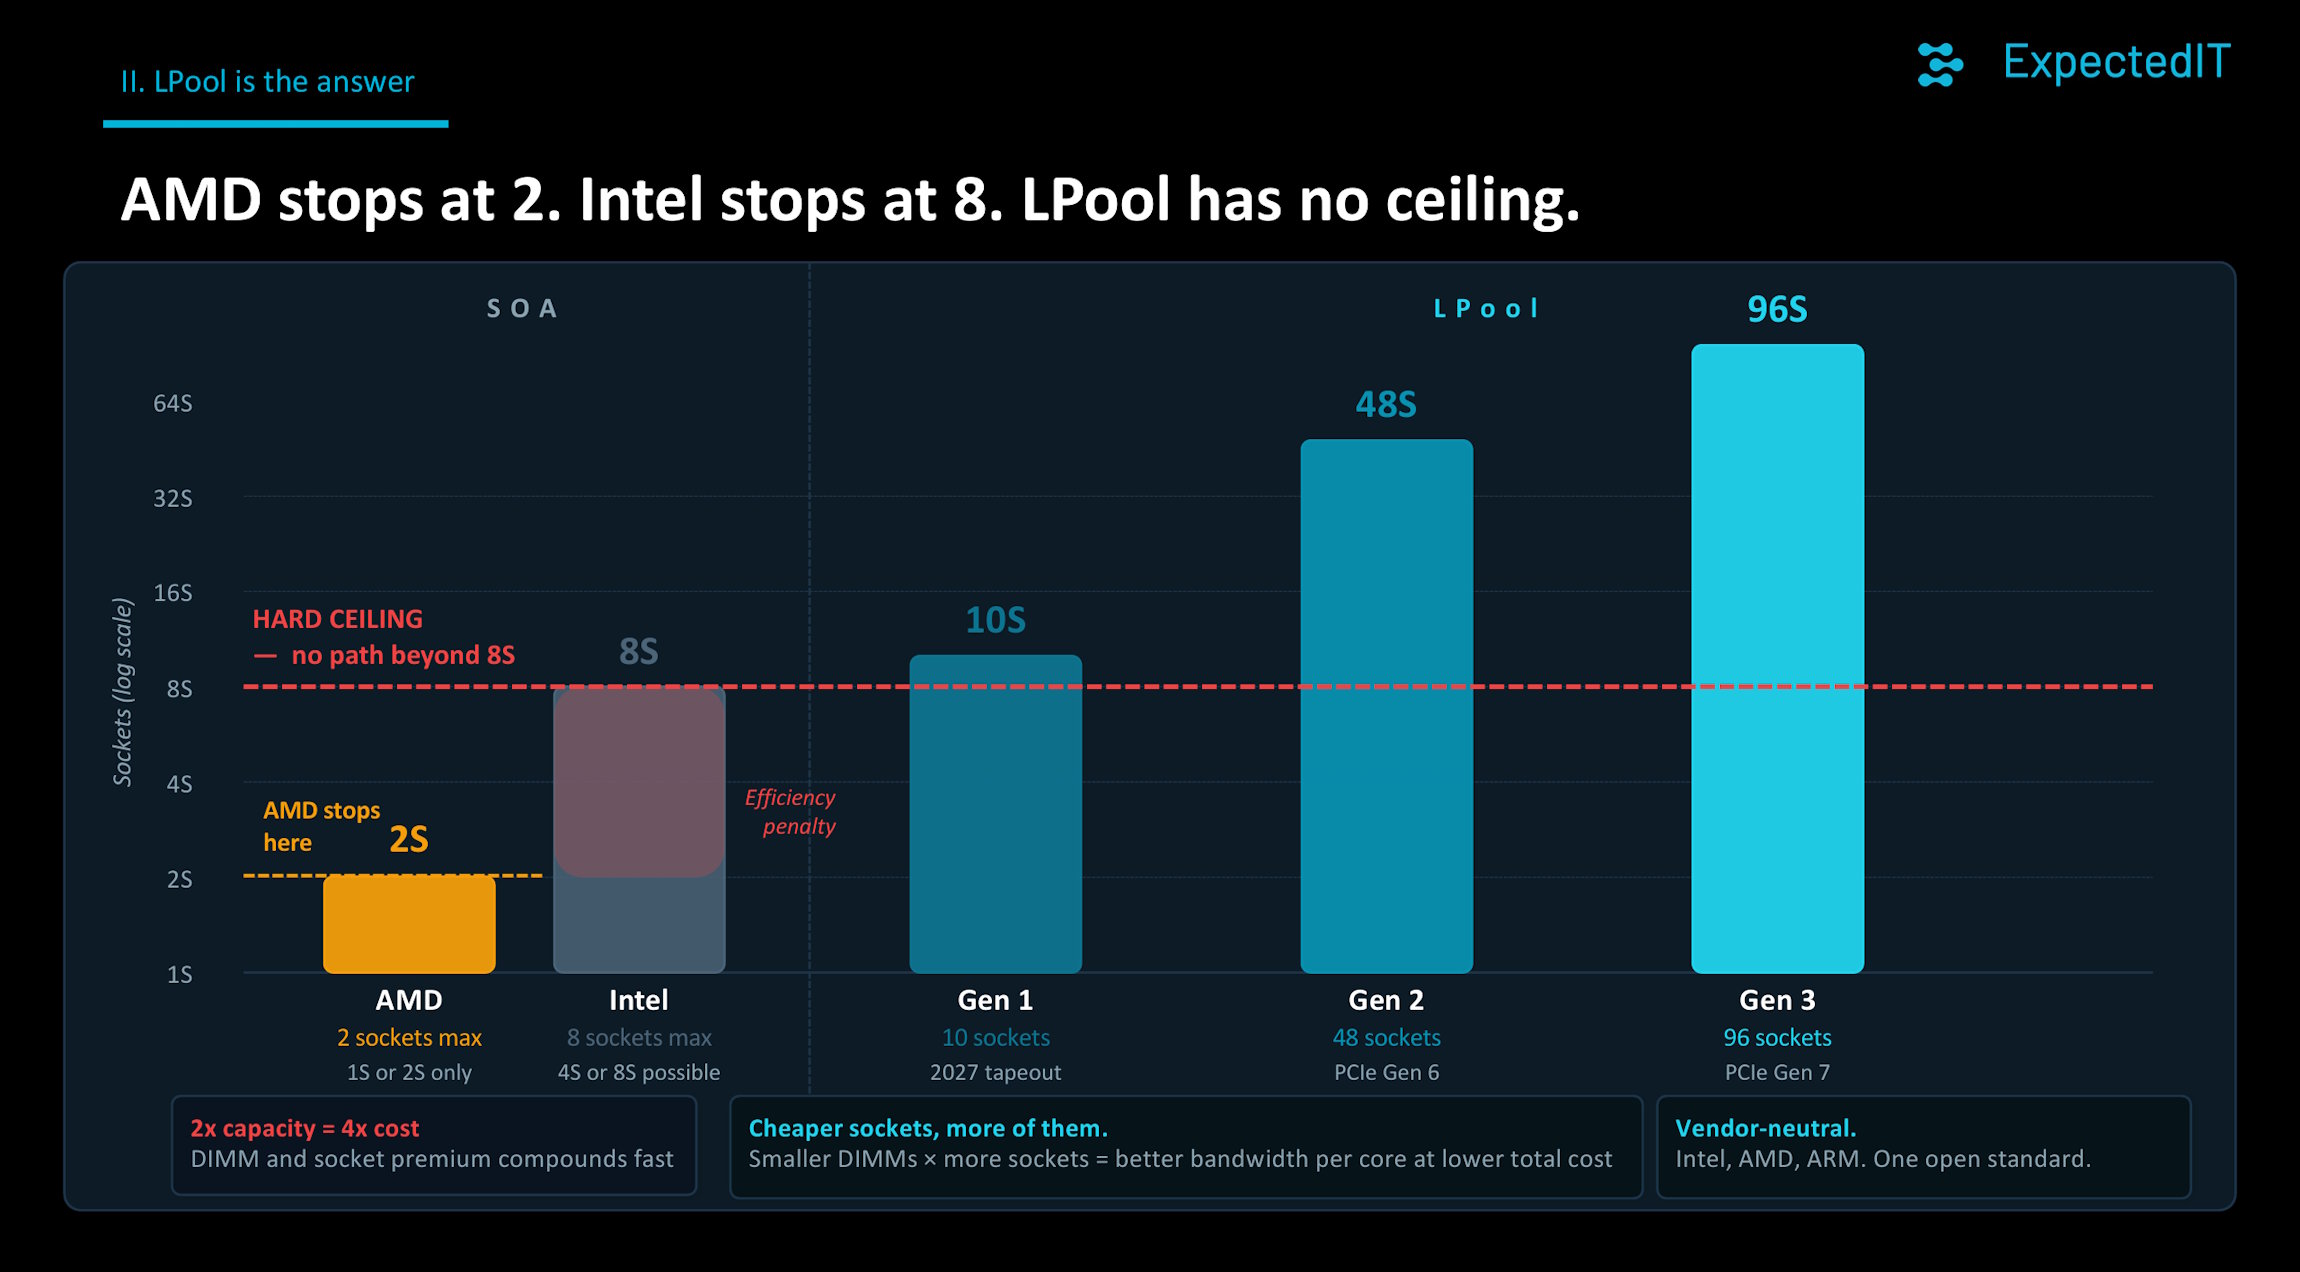
« AMD s’arrête à deux sockets, Intel à huit »
Quiconque veut construire un grand serveur aujourd’hui se heurte rapidement à un plafond. AMD couple au maximum deux sockets, Intel huit, et ceux qui s’approchent de ces limites paient le prix fort : les plus grands sockets et modules de mémoire coûtent facilement quatre à huit fois plus cher que le milieu de gamme. ExpectedIT promet « aucun plafond », bien que la réalité soit pour l’instant plus modeste. La première génération de puces LPool passe à dix sockets, la deuxième à 48 via PCIe Gen 6, et la troisième à 96 via PCIe Gen 7.
Selon Moreau, ce sont surtout les hyperscalers qui sont à l’écoute. Ils veulent un type de serveur unique, bon marché et générique, doté de processeurs et d’une mémoire modestes, et pouvoir le faire évoluer selon les besoins à l’échelle du rack. En cela, LPool se rapproche du CXL, l’interconnexion que les hyperscalers déploient aujourd’hui pour partager la mémoire.
Moreau, lui-même actif dans le camp CXL pendant des années, voit une différence majeure. « LPool se situe au même niveau que le CPU et ne nécessite pas de couche de commutation supplémentaire avec le matériel et la consommation d’énergie associés. » Il fait référence au document Beluga d’Alibaba, dans lequel la mémoire couplée par CXL a rendu le cache KV de l’inférence IA jusqu’à sept fois plus rapide, et affirme pouvoir faire aussi bien, voire mieux, avec LPool grâce à une latence plus faible. « LPool pourrait potentiellement remplacer le partage de mémoire du CXL », espère-t-il. Dans le même temps, il admet que le CXL est désormais inarrêtable.
L’idée d’une infrastructure composable n’est d’ailleurs pas totalement nouvelle : des acteurs comme Liqid suivent un chemin similaire depuis un certain temps. ExpectedIT ne prétend pas non plus s’accaparer tout le marché. Les serveurs à un ou deux sockets resteront les bêtes de somme du centre de données ; Moreau vise tout au plus 20 à 40 % du marché, y compris les hyperscalers.
Pas de LPool sans écosystème
La nouvelle la plus marquante de notre entretien : le Xeon 7 d’Intel, qui sortira l’année prochaine, prend en charge le partage de mémoire LPool. Cela semble impressionnant, mais il est important de savoir qu’Intel n’a pas intégré la technologie d’ExpectedIT dans ses processeurs. C’est ExpectedIT qui a construit son partage de mémoire sur UPI, le protocole d’interconnexion propre à Intel. Moreau a fièrement annoncé par la même occasion avoir obtenu la licence d’utilisation de ce protocole il y a quelques semaines.
AMD n’a pas été le premier sollicité car il ne dispose pas d’interconnexion native au-delà de deux sockets. Des discussions sont en cours avec AMD et ARM, mais rien de concret n’a encore été décidé.
Les cartes mères doivent être conçues avec une puce LPool par CPU et un câblage entre les serveurs du rack. ExpectedIT doit donc collaborer avec Supermicro, Dell, HPE et Lenovo.
Il n’est pas non plus possible de mettre à jour les serveurs existants. Les cartes mères doivent être conçues avec une puce LPool par CPU et un câblage entre les serveurs du rack. ExpectedIT doit donc convaincre Supermicro, Dell, HPE et Lenovo, ou les hyperscalers eux-mêmes avec des modèles personnalisés, de construire des cartes mères adaptées. Aucun de ces acteurs n’a signé à ce jour.
Ensuite, il y a la production. LPool nécessite un procédé avancé d’environ six nanomètres, et pour cela, ExpectedIT ne peut s’adresser qu’à TSMC, Samsung ou Intel. C’est regrettable pour une entreprise que l’Europe considère comme une technologie stratégique, avec une bourse de l’EIC figurant parmi les 4 % meilleurs dossiers sur plus de mille demandes. La puce européenne souveraine doit, par définition, être fabriquée hors de l’UE.
D’abord 25 millions d’euros, ensuite une puce
En octobre, ExpectedIT ouvrira un tour de table de série A de 25 millions d’euros, dont jusqu’à dix millions de fonds propres de l’EIC, qui devrait être clôturé fin mars 2027. Le seul « tape-out » de la puce coûte environ dix millions d’euros. Si cela réussit, des échantillons suivront fin 2027 et les premières machines seront chez les partenaires en 2028, dans le meilleur des cas.
Ensuite, une série B d’environ 60 millions d’euros sera nécessaire. Au total, ExpectedIT estime avoir besoin de 100 à 120 millions d’euros. Moreau résume parfaitement le paradoxe européen : « Les investisseurs américains disent que nous ne demandons pas assez. Les investisseurs européens trouvent que c’est beaucoup d’argent. »
Selon Moreau, la traction est là. ExpectedIT a signé des lettres d’intention avec le développeur d’IA FractalBrain, l’opérateur cloud Core42 (une filiale de la société émiratie G42) et l’hébergeur islandais 1984 ehf. Des négociations sont en cours avec le fabricant européen de CPU SiPearl.
Les équipes d’ingénierie de Microsoft et Meta ont confirmé l’architecture de manière indépendante, et le pionnier d’Internet Vint Cerf siège au conseil consultatif. Une liste impressionnante pour une entreprise de vingt personnes, mais il s’agit de lettres d’intention, pas de commandes. Moreau ne s’en cache pas : « C’est un pari. La traction semble arriver, mais je ne serai sûr que lorsque le tour de table A sera bouclé et que nous commencerons à fabriquer des puces. »
Une théorie prometteuse en quête de silicium
L’IA agentique fait du côté CPU du centre de données un goulot d’étranglement, et la solution d’ExpectedIT est confirmée par AMD, Nvidia et des chercheurs. La solution est élégante, l’équipe possède le bon bagage avec des références issues d’IBM et d’Ericsson, et Moreau est d’une honnêteté rafraîchissante quant aux risques. C’est une rareté dans les présentations d’IA, mais c’est peut-être obligatoire en tant qu’acteur de l’UE.
Pourtant, la comparaison avec NVLink flatte et démasque à la fois ce qui fait d’un rack un seul GPU. Nvidia peut imposer son interconnexion au marché parce qu’il vend lui-même les GPU. ExpectedIT ne possède ni CPU, ni cartes mères, ni usine, et doit faire bouger simultanément Intel, AMD, les OEM et les hyperscalers.
ExpectedIT ne possède ni CPU, ni cartes mères, ni usine, et doit faire bouger simultanément Intel, AMD, les OEM et les hyperscalers.
La puce ne sera là qu’au plus tôt fin 2027, et seulement si un marché européen du capital-risque, traditionnellement réticent vis-à-vis des semi-conducteurs, met 25 millions d’euros sur la table. Les étapes à franchir sont claires : résultats de démonstration fin septembre, tour de financement A d’ici mars 2027, premières puces plus tard cette année-là et premières machines en 2028. D’ici là, « le rack est le CPU » reste une théorie prometteuse, mais que Intel, Microsoft et Meta prennent suffisamment au sérieux pour y associer leur nom.